テキストセグメンテーション
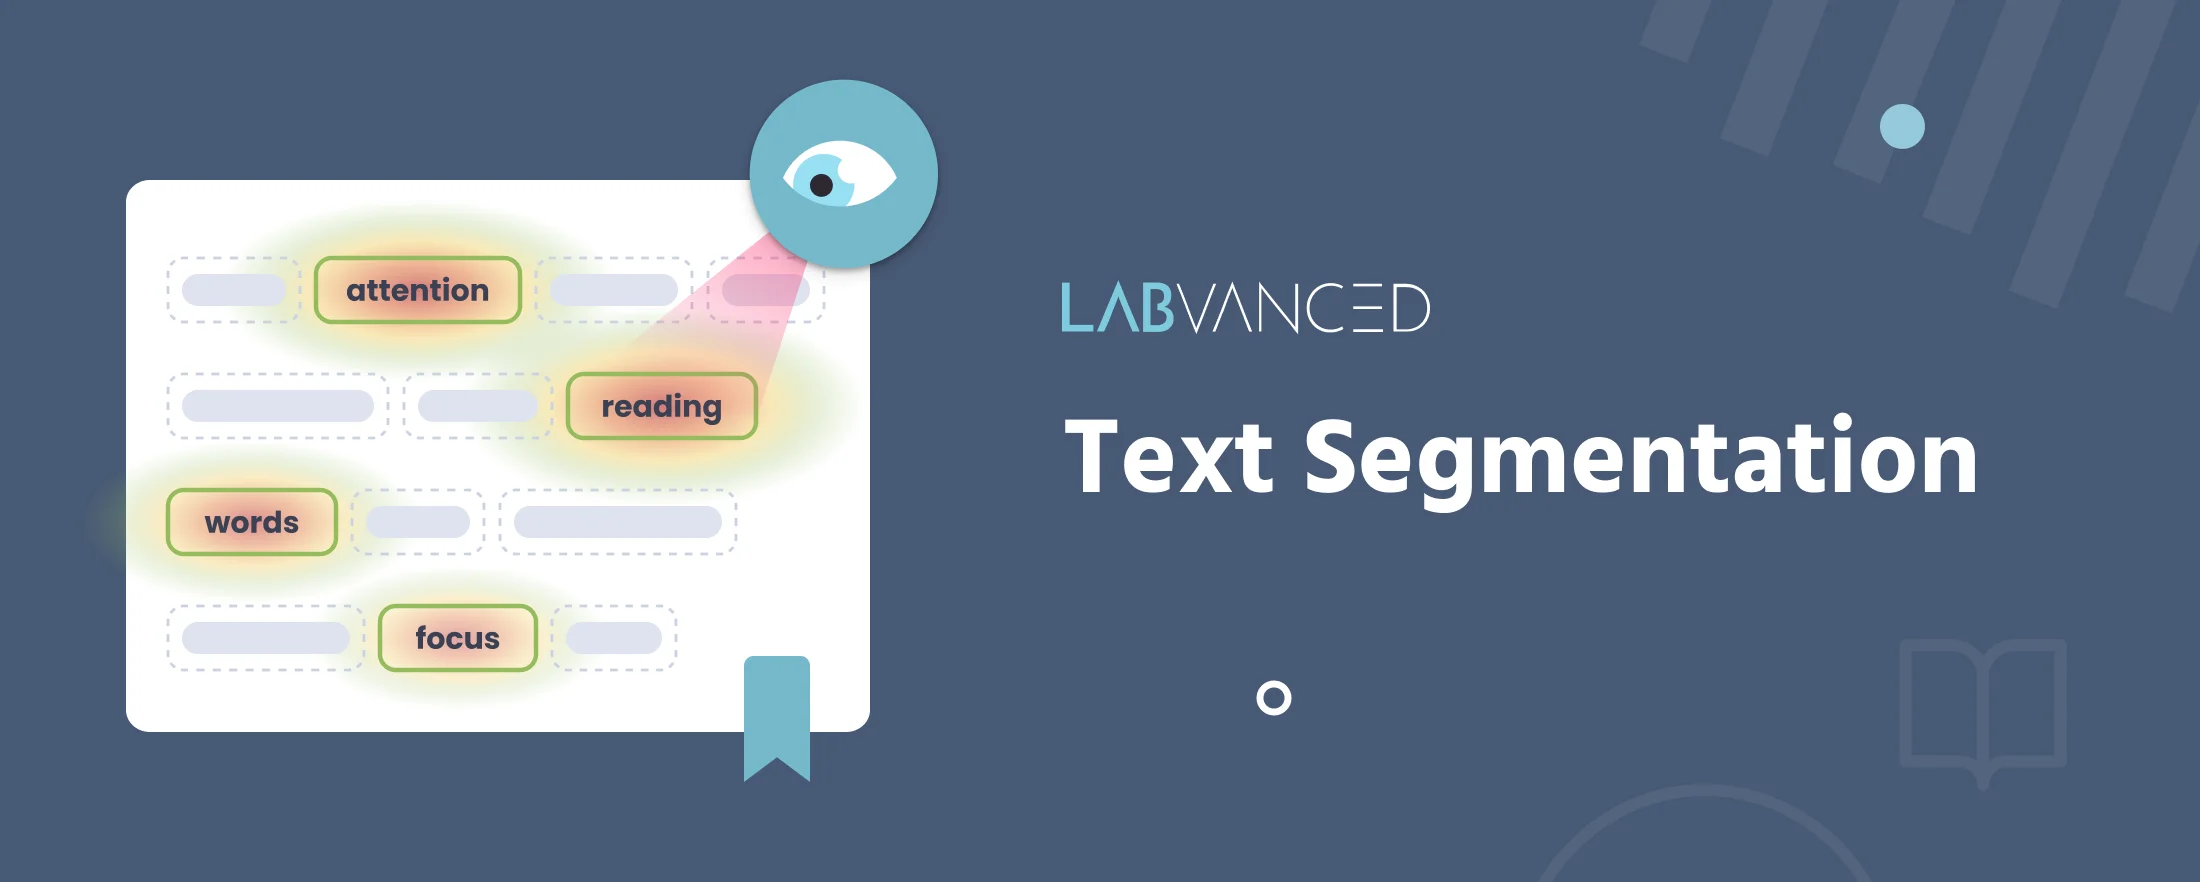
Labvancedのテキストセグメンテーションにより、研究者は文中の各単語の単語レベルの興味領域を自動的に数分で構築できます。手動でのAOI配置は不要です:刺激のスプレッドシートをリンクし、Labvancedが各単語の位置を測定し、ウェブカメラによる視線追跡を有効にすると、各単語、各試行につき5つの視線メトリクスを記録します。
テキストセグメンテーションの仕組み
単語ごとまたは領域ごとの視線データに基づく読書研究は、歴史的に刺激のすべての単語またはフレーズに対してAOIを手動で配置することを意味しており、このプロセスはごく少数の文を超えては拡張できませんでした。Labvancedのテキストセグメンテーションはそのステップを取り除きます:文のスプレッドシートをアップロードし、各行のすべての単語が研究者が一つのボックスも配置することなく、自分のAOIを持ちます。
| プロパティ | 仕様 |
|---|---|
| テキストソース | CSVアップロード、既存のデータフレーム、または配列変数(試行ごとに1つの文) |
| AOIユニット | 単語ごとに1つのボックス、Labvancedフレーム単位で自動的に測定 |
| レイアウトモード | フロー(要素の幅で折り返す)またはグリッド(等幅の列、隙間のないAOIカバレッジ) |
| 記録されたテーブル | AOIジオメトリ(単語、位置、サイズ)および視線追跡がオンの場合、単語ごとの視線メトリクス |
| 単語ごとの視線メトリクス | 滞在時間、総注視回数、総注視持続時間、初回注視までの時間、平均注視持続時間 |
| 互換性 | 縦断的デザイン、マウストラッキングなど |
各単語のAOIは、レンダリングされた要素から直接測定され、フォントメトリクスから推定されないため、記録されたジオメトリは試行が表示されたときに実際に画面上にあったものと一致します。これが記録された場合の様子については、下のAOIジオメトリテーブルを参照してください。
単語ごとの視線メトリクスはLabvancedの査読されたウェブカメラ視線追跡パイプライン上で実行されます(1.3視覚デグリーの精度、EyeLink 1000に対して検証済み;Kaduk et al., 2024, Behavior Research Methods)、プラットフォーム上の他のすべての視線追跡機能の背後にある同じ視線エンジンです。これが記録された場合の様子については、下の単語ごとのメトリクステーブルを参照してください。
手動配置の代わりに自動AOI
スプレッドシート形式は、この種の研究のために刺激が通常どのように構築されるかと一致しており、試行ごとに1行、列ごとに1単語であるため、既存の刺激セットはしばしば直接リンクできます。
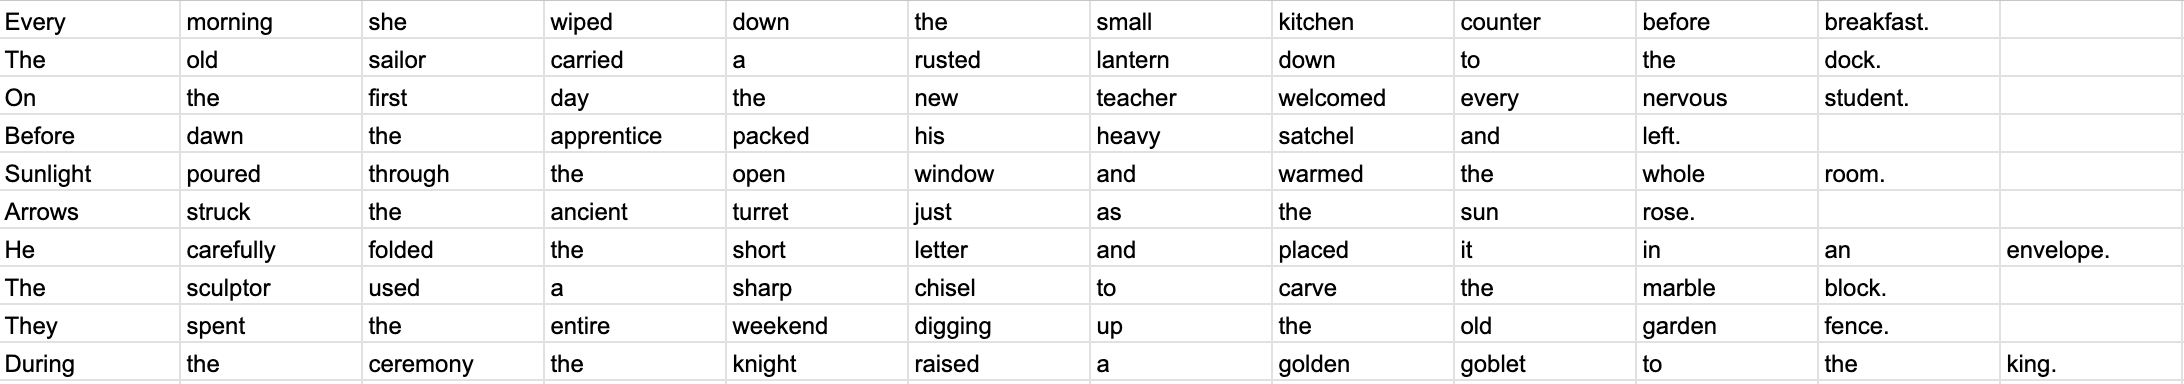
ほんの数分で、CSVからLabvancedで完全に機能するプロトタイプ研究に移行でき、AOIがマッピングされ、ウェブカメラ視線追跡が有効になります。
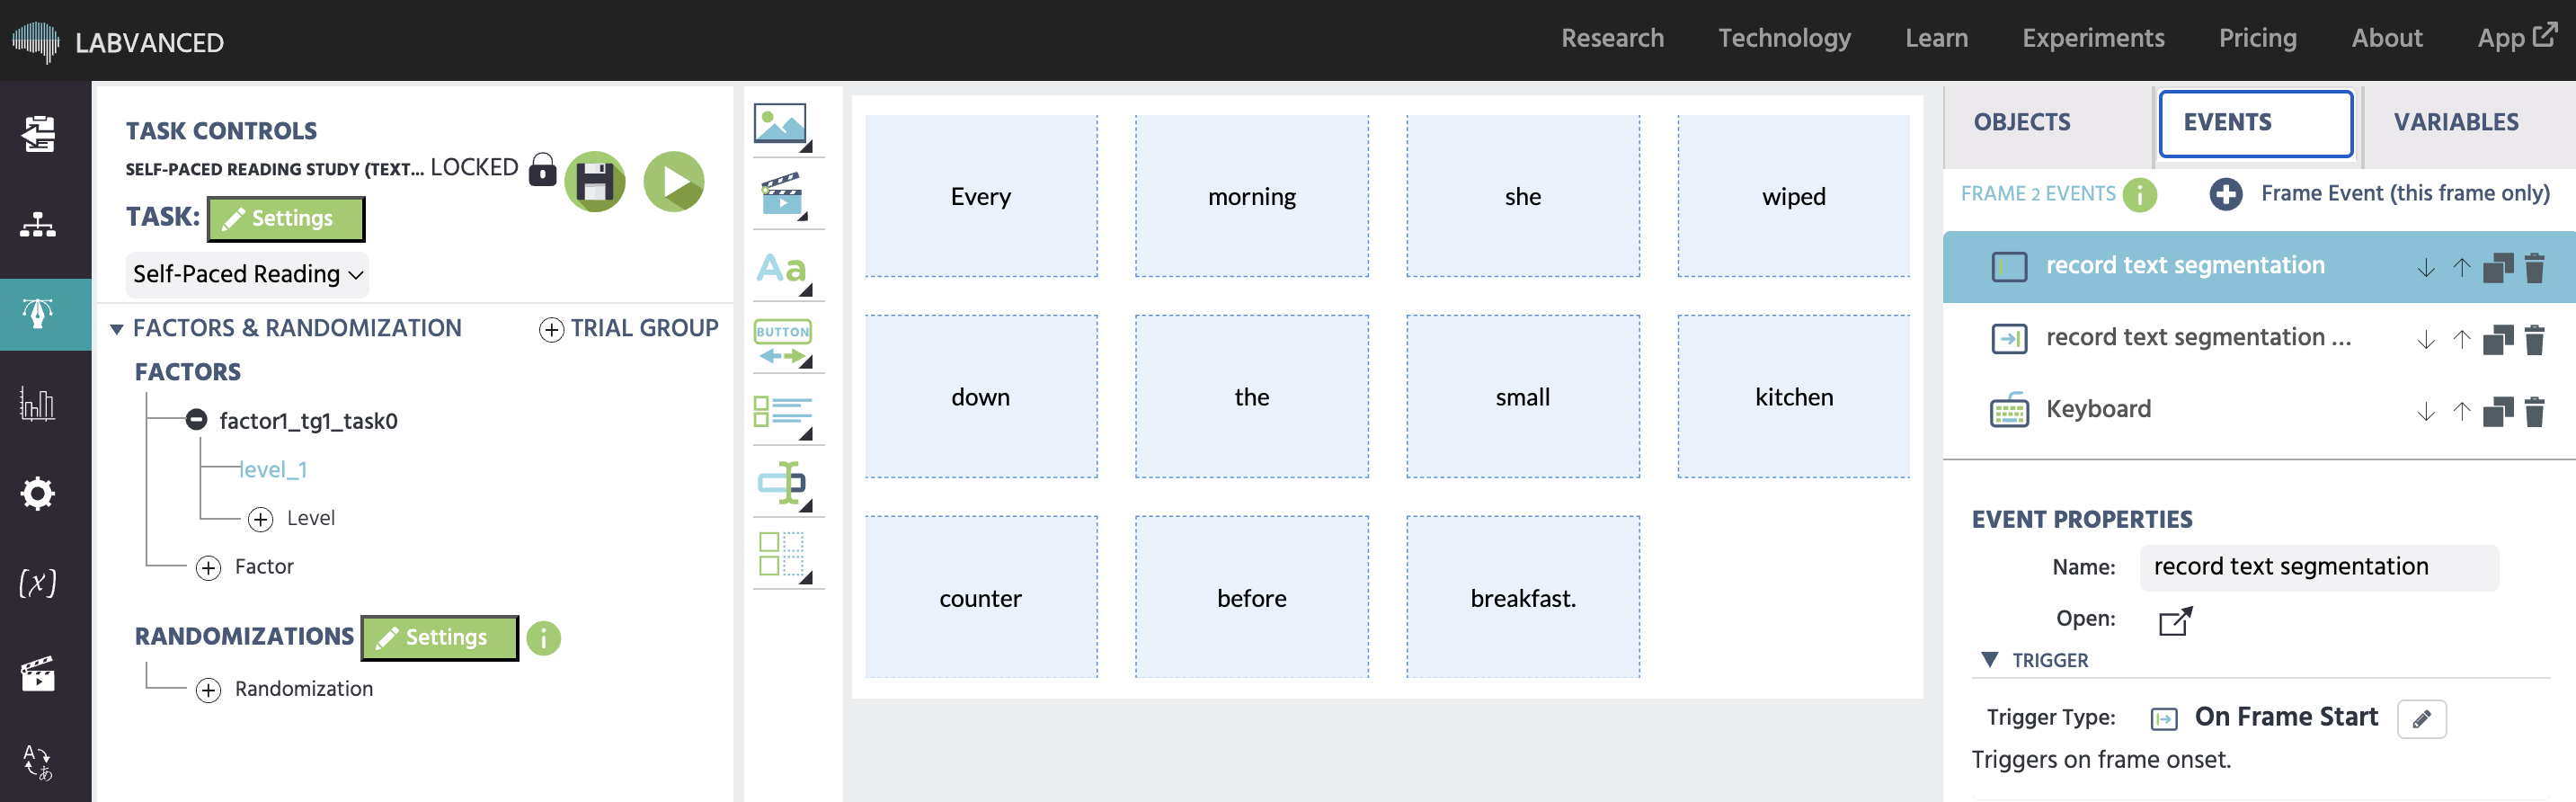
収集されたデータとプレビュー
試行ごとに2つのデータフレームテーブルが利用可能で、行が一致しているため、同じ単語が両方のテーブルで同じ行に存在します。
| AOIジオメトリテーブル | 単語ごとのメトリクステーブル |
|---|---|
word_index, word, line_index, x, y, width, height | word_index, word, line_index, dwell_time, total_fixations, total_fixation_duration, time_to_first_fixation, mean_fixation_duration |
見られなかった単語は、各メトリクス列にゼロを保持し、空のセルではなくその行を維持するため、分析スクリプトは欠損データを特別扱いする必要がありません。
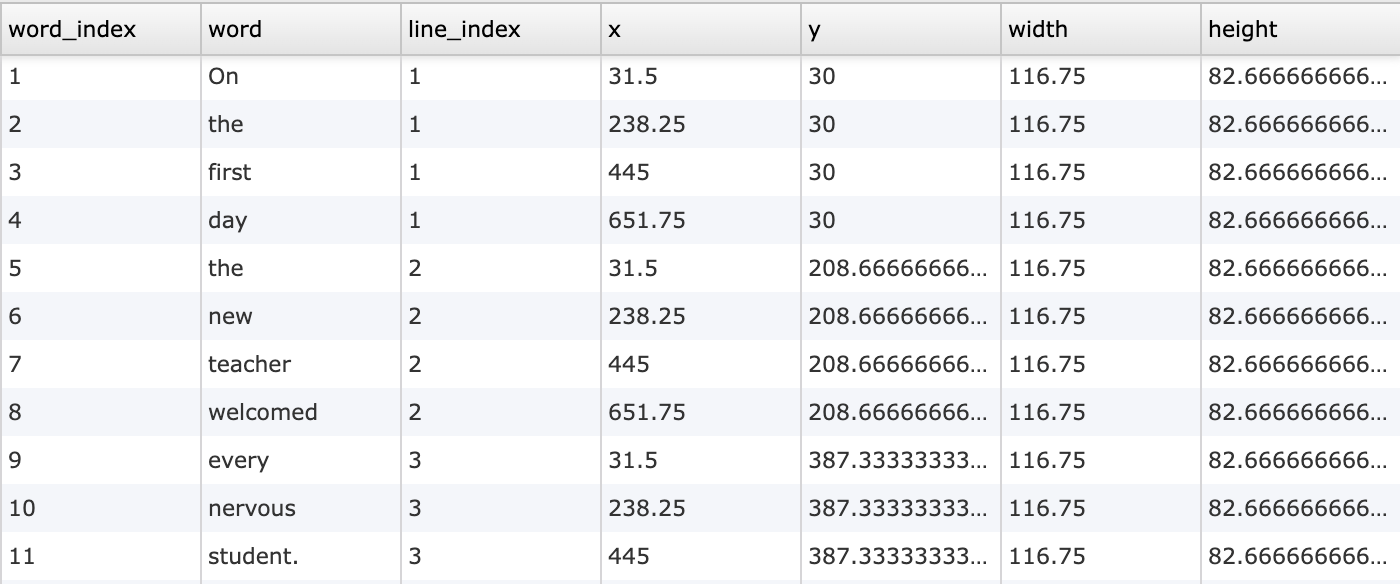
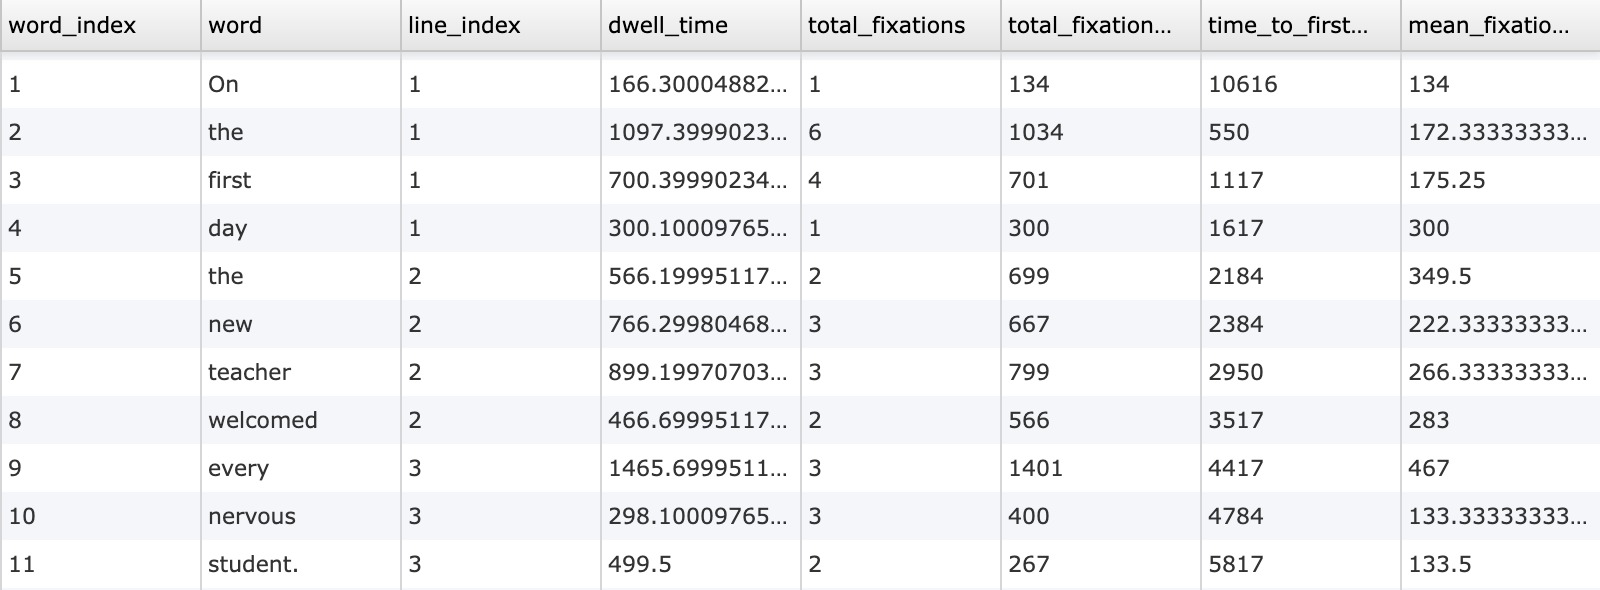
両方のテーブルは専用のイベントアクションによって書き込まれます:Record Text Segment AOIsがフレームの開始時にジオメトリを書き込み、レンダリングされたものに追従させ、Record Text Segment Eyetracking Metricsがフレームの終了時に視線メトリクスを書き込み、その試行のすべての単語の注視データが最終的になります。
インタラクティブデモ
この研究の完全なタスク設定、記録された変数、および研究の応用は自己ペースリーディングタスクページに記載されています。
ドキュメンテーション
テキストセグメンテーションオブジェクト
完全なオブジェクト参照:プロパティ、セットアップウィザード、および2つの記録アクション。
読書研究の構築
テキストセグメンテーションを使って実際の単語頻度リーディング研究を構築するステップバイステップのウォークスルー。