文本分割
Labvanced中的文本分割允许研究人员在几分钟内自动为句子中的每个单词构建一个单词级兴趣区。无需手动AOI放置:链接一个刺激的电子表格,Labvanced测量每个单词的位置,然后在启用网络摄像头眼动追踪的情况下,为每个单词、每个试验记录五个注视指标。
文本分割如何工作
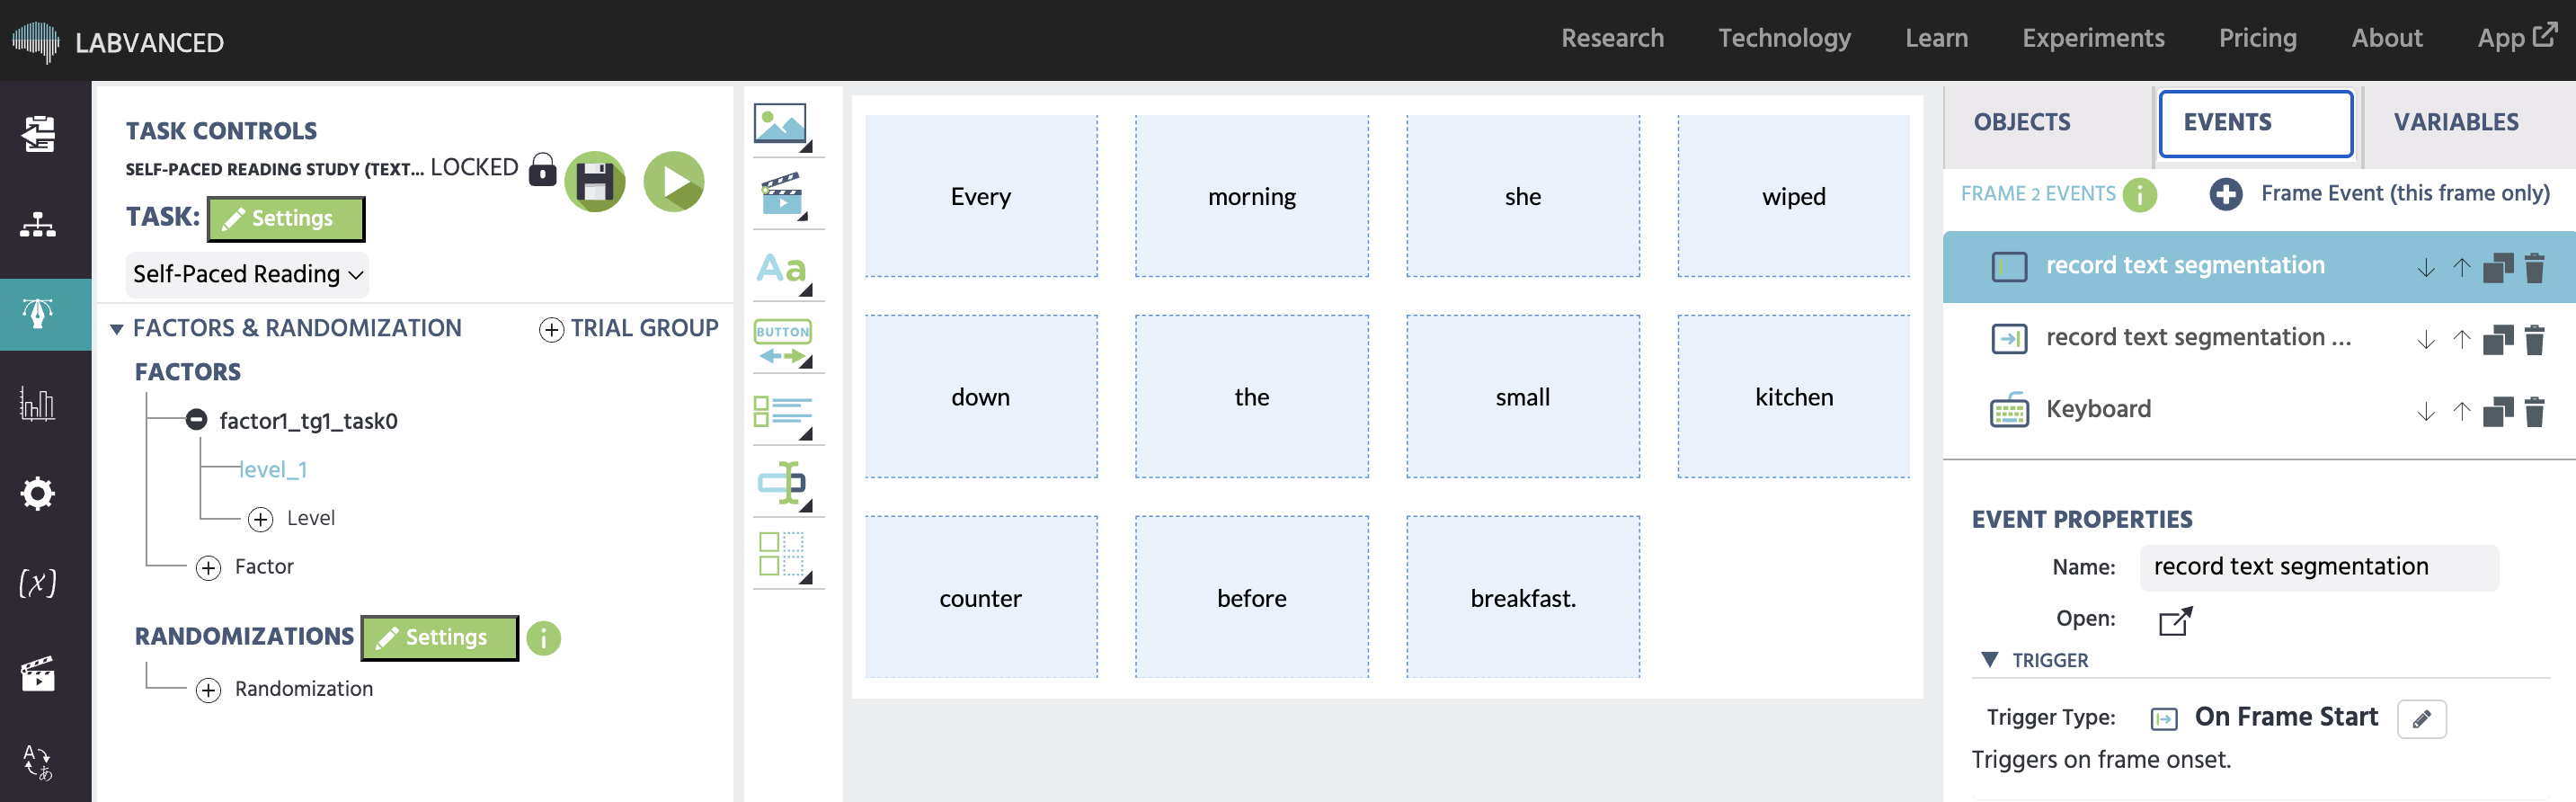
围绕每词或每区域注视数据构建的阅读研究历史上意味着为每个刺激中的每个单词或短语手动放置一个AOI,这一过程在超出少数句子时并不能很好扩展。 Labvanced中的文本分割移除了这一步:上传一个句子的电子表格,电子表格中每行的每个单词都获得自己的AOI,无需研究人员放置一个单独的框。
| 属性 | 规格 |
|---|---|
| 文本来源 | CSV上传,现有数据框,或数组变量(每次试验一个句子) |
| AOI单元 | 每个单词一个框,自动以Labvanced帧单位测量 |
| 布局模式 | 流程(在元素宽度处换行)或网格(等宽列,无间隙的AOI覆盖) |
| 记录的表格 | AOI几何(单词、位置、大小)以及启用眼动追踪时的每词注视指标 |
| 每词注视指标 | 停留时间、总注视次数、总注视持续时间、到首次注视时间、平均注视持续时间 |
| 兼容性 | 纵向设计、鼠标跟踪等 |
每个单词的AOI是直接从渲染的元素中测量的,而不是从字体指标中估算的,因此记录的几何图形与试验显示时实际上在屏幕上的内容相匹配。请参见下面的 AOI几何表,了解记录时的样子。
每词注视指标基于Labvanced的经过同行评审的网络摄像头眼动追踪管道(准确度为1.3视觉度,经过EyeLink 1000验证;Kaduk等,2024,行为研究方法),这是平台上所有其他眼动追踪能力背后的相同注视引擎。请参见下面的 每词指标表,了解记录时的样子。
自动AOIs而非手动放置
电子表格格式与这种研究通常构建刺激的方式相匹配,每行一个试验,每列一个单词,因此可以直接链接现有的刺激集。
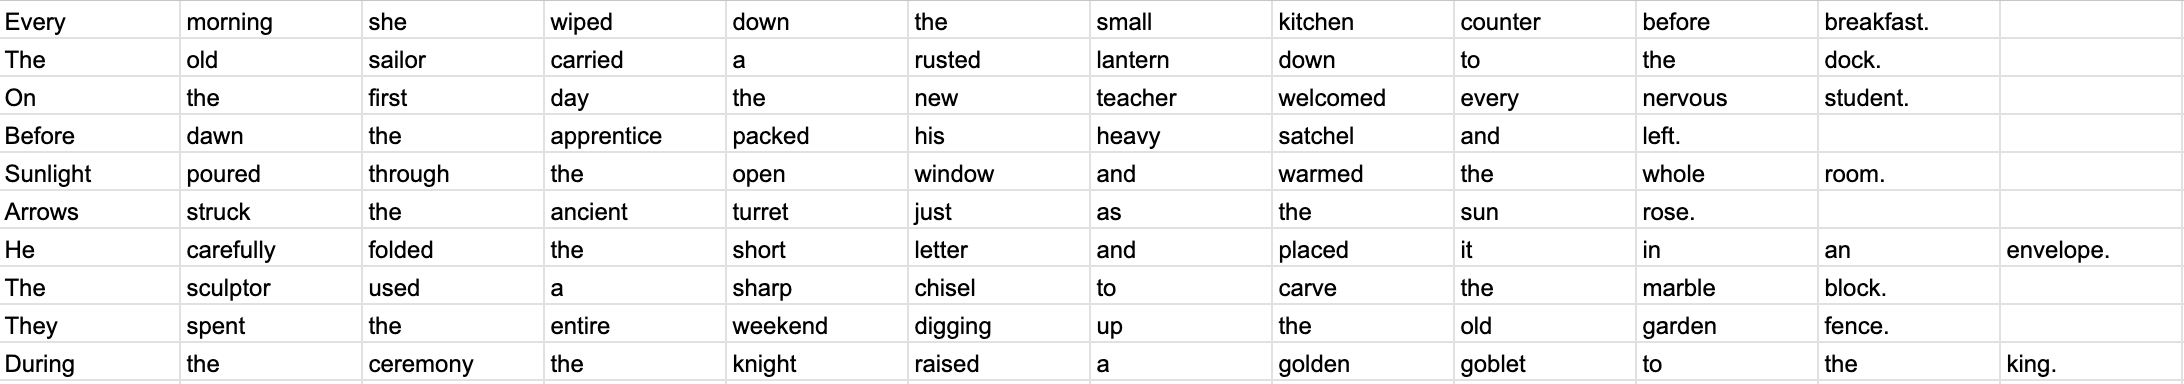
只需几分钟,您就可以从CSV转换为Labvanced中功能完全的原型研究,AOIs被映射并启用了网络摄像头眼动追踪。
收集的数据和预览
每个试验提供两个数据框表格,行对齐,因此同一个单词在两个表中占据同一行:
| AOI几何表 | 每词指标表 |
|---|---|
word_index, word, line_index, x, y, width, height | word_index, word, line_index, dwell_time, total_fixations, total_fixation_duration, time_to_first_fixation, mean_fixation_duration |
从未被注视的单词在每个指标列中保持其行,并用零填充,而不是空单元格,因此没有分析脚本需要特殊处理缺失数据。
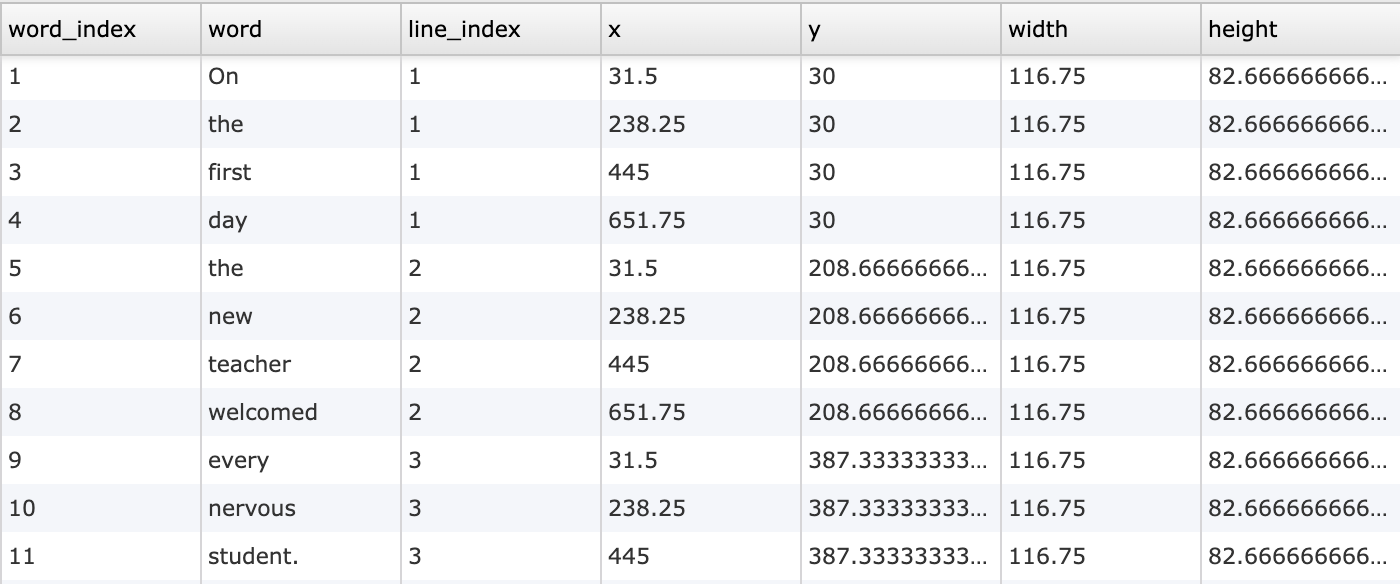
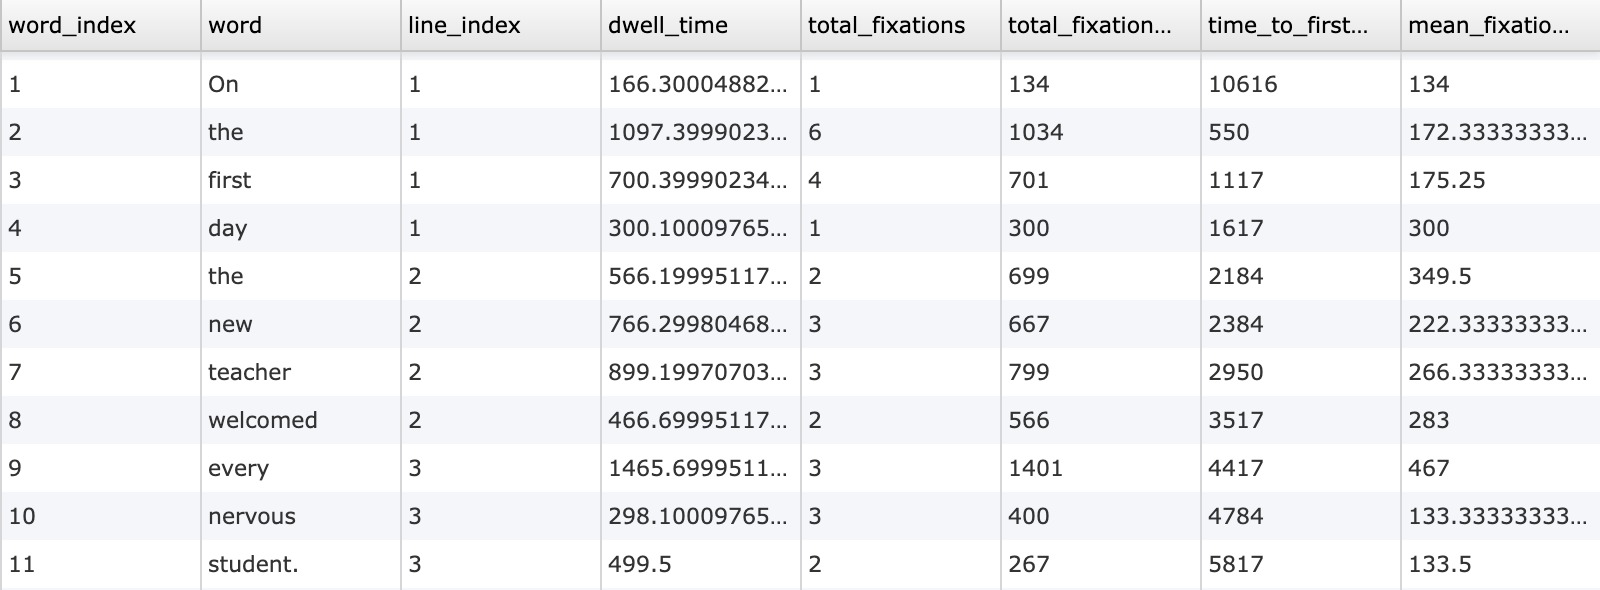
这两个表格通过专用事件动作写入:Record Text Segment AOIs 在帧开始时写入几何,并保持与所渲染内容的步调一致;Record Text Segment Eyetracking Metrics 在帧结束时写入注视指标,一旦每个单词的注视数据在该试验中确定。
互动演示
完整的任务设置、记录的变量和该研究的研究应用在自我调节阅读任务页面中描述。