Textsegmentierung
Die Textsegmentierung in Labvanced ermöglicht es Forschern, für jedes Wort in einem Satz automatisch in nur wenigen Minuten eine Wort-niveau Area of Interest zu erstellen. Es gibt keine manuelle AOI-Platzierung: Verbinden Sie eine Tabelle mit Stimuli und Labvanced misst die Position jedes Wortes, dann, mit aktivierter Webcam-Augenverfolgung, werden fünf Blickmetriken pro Wort und pro Versuch aufgezeichnet.
Inhaltsverzeichnis
Wie die Textsegmentierung funktioniert
Leseuntersuchungen, die auf per-Wort- oder per-Bereich-Blickdaten basieren, bedeuteten historisch, dass für jedes Wort oder jede Phrase in jedem Stimulus eine AOI manuell plaziert werden musste, ein Prozess, der über eine Handvoll Sätze hinaus nicht skalierbar ist. Die Textsegmentierung in Labvanced entfernt diesen Schritt: Laden Sie eine Tabelle mit Sätzen hoch, und jedes Wort in jeder Zeile erhält seine eigene AOI, ohne dass ein Forscher eine einzige Box platzieren muss.
| Eigenschaft | Spezifikation |
|---|---|
| Textquelle | CSV-Upload, vorhandenes Datenrahmen oder Array-Variable (ein Satz pro Versuch) |
| AOI-Einheit | Eine Box pro Wort, automatisch in Labvanced-Rahmeneinheiten gemessen |
| Layout-Modi | Flow (wickelt sich bei Elementbreite) oder Grid (gleich breite Spalten, lückenlose AOI-Abdeckung) |
| Aufgezeichnete Tabellen | AOI-Geometrie (Wort, Position, Größe) und, bei aktivierter Augenverfolgung, per-Wort-Wohlstandsmetriken |
| Per-Wort-Blickmetriken | Verweildauer, Gesamtfixationen, Gesamtdauer der Fixationen, Zeit bis zur ersten Fixation, durchschnittliche Fixationsdauer |
| Kompatibel mit | Längsschnittdesigns, Mausverfolgung und mehr |
Die AOI jedes Wortes wird direkt aus dem gerenderten Element gemessen, nicht aus Schriftarten geschätzt, sodass die aufgezeichnete Geometrie dem entspricht, was tatsächlich auf dem Bildschirm war, als der Versuch es anzeigte. Sehen Sie sich die AOI-Geometrietabelle unten an, um zu sehen, wie dies aufgezeichnet aussieht.
Die per-Wort-Blickmetriken laufen auf Labvanceds peer-reviewten Webcam-Augenverfolgung-Pipeline (1,3 visuelle Genauigkeit, validiert gegen ein EyeLink 1000; Kaduk et al., 2024, Behavior Research Methods), demselben Blickengine hinter jeder anderen Augenverfolgungsfähigkeit auf der Plattform. Sehen Sie sich die per-Wort-Metrik-Tabelle unten an, um zu sehen, wie dies aufgezeichnet aussieht.
Automatische AOIs statt manueller Platzierung
Das Tabellenformat entspricht bereits der Art und Weise, wie Stimuli für diese Art von Studie normalerweise erstellt werden, eine Zeile pro Versuch, ein Wort pro Spalte, sodass ein vorhandenes Stimulusset oft direkt verknüpft werden kann.
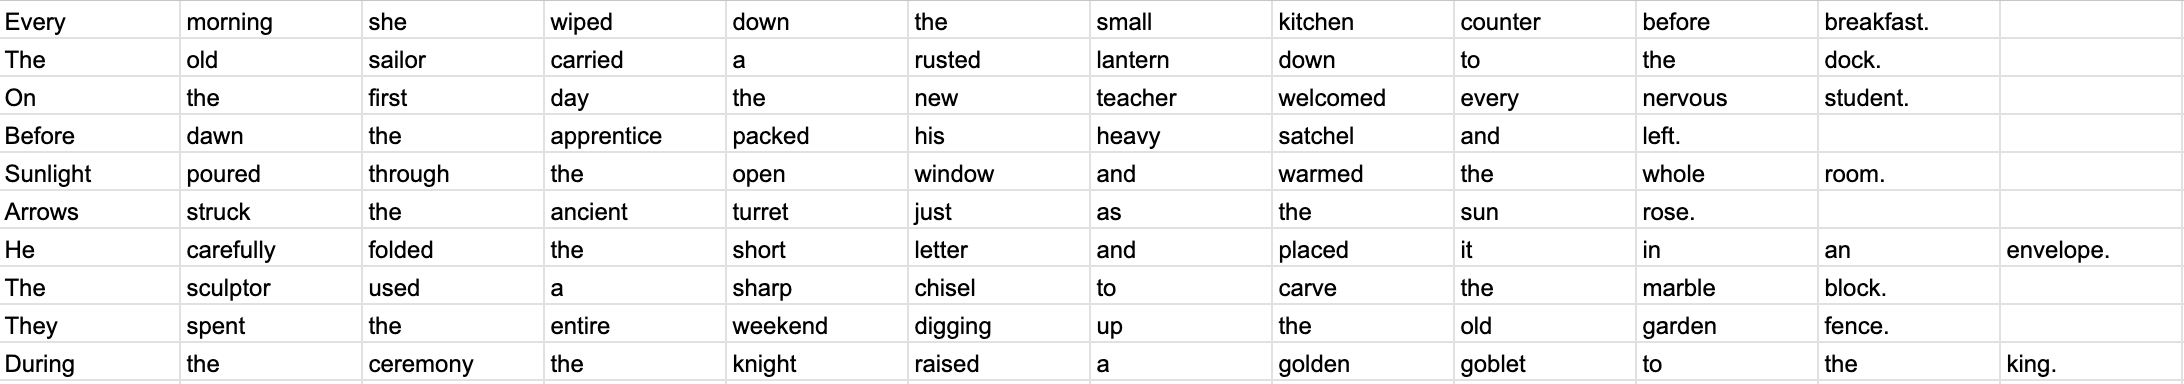
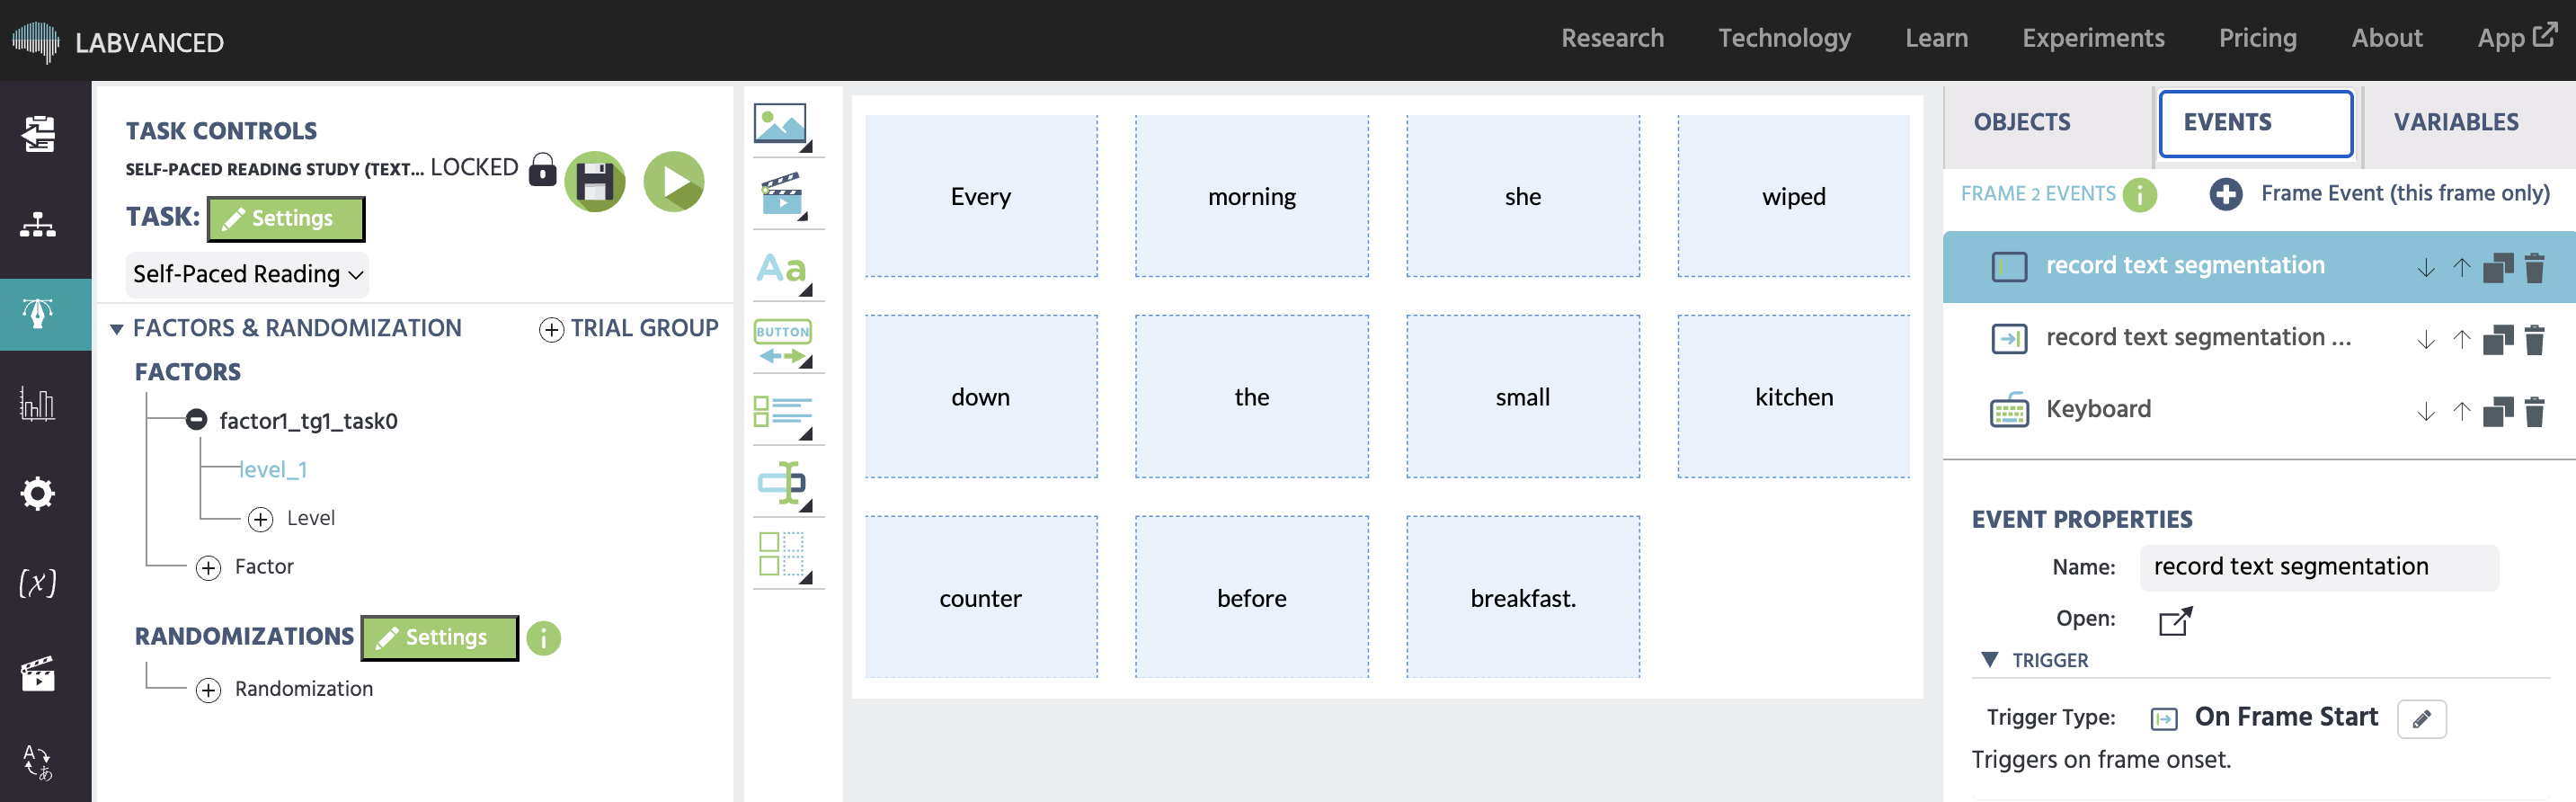
In nur wenigen Minuten können Sie von einer CSV zu einer voll funktionsfähigen Prototypstudie in Labvanced gelangen, mit AOIs, die gemappt sind und aktivierter Webcam-Augenverfolgung.
Gesammelte Daten und Vorschau
Für jeden Versuch sind zwei Datenrahmen-Tabellen verfügbar, zeilenabgestimmt, sodass dasselbe Wort in beiden die gleiche Zeile einnimmt:
| AOI-Geometrietabelle | Per-Wort-Metriken-Tabelle |
|---|---|
word_index, word, line_index, x, y, width, height | word_index, word, line_index, dwell_time, total_fixations, total_fixation_duration, time_to_first_fixation, mean_fixation_duration |
Ein Wort, das nie betrachtet wurde, behält seine Zeile mit Nullen über jede Metrik-Spalte hinweg bei, anstatt eine leere Zelle zu haben, sodass kein Analyse-Skript fehlende Daten speziell behandeln muss.
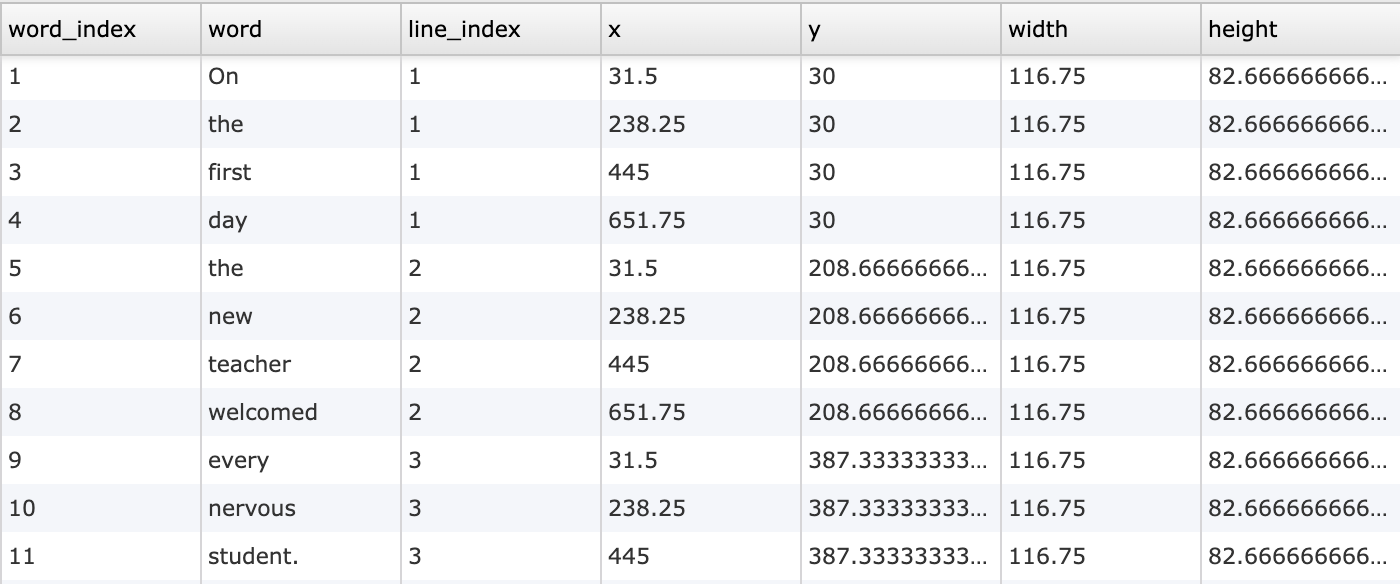
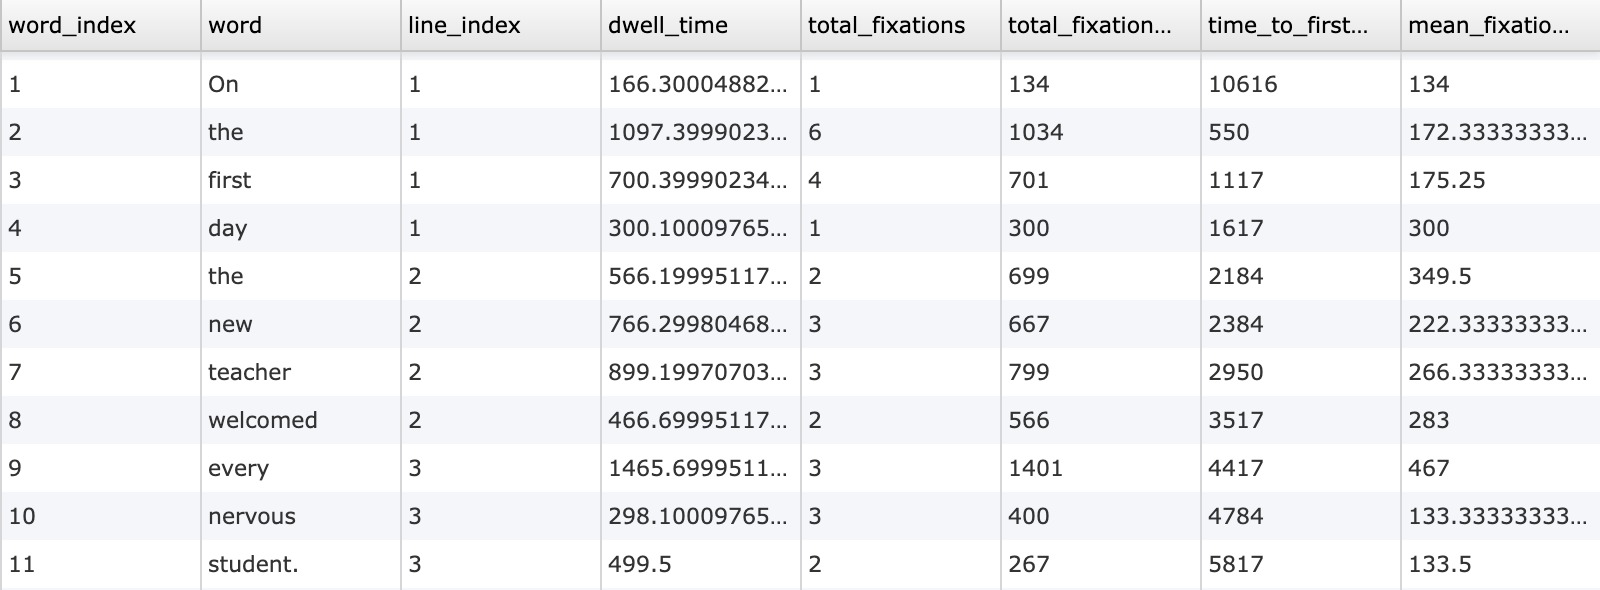
Beide Tabellen werden von dedizierten Ereignisaktionen geschrieben: Record Text Segment AOIs schreibt die Geometrie zu Beginn eines Rahmens und hält sie im Einklang mit dem, was gerendert wird, und Record Text Segment Eyetracking Metrics schreibt die Blickmetriken am Ende des Rahmens, sobald die Fixationsdaten jedes Wortes für diesen Versuch final sind.
Interaktive Demos
Der vollständige Aufbau der Aufgabe, die aufgezeichneten Variablen und die Forschungsanwendungen dieser Studie sind auf der Selbstgesteuerten Leseaufgaben-Seite beschrieben.
Dokumentation
Textsegmentierungsobjekt
Vollständige Objektreferenz: Eigenschaften, Einrichtungsassistent und die beiden Aufnahmeaktionen.
Aufbau einer Leseuntersuchung
Schritt-für-Schritt-Anleitung zu einer realen Wort-Häufigkeits-Leseuntersuchung, die mit der Textsegmentierung aufgebaut wurde.
Häufige Fragen
Kann Labvanced automatisch eine AOI für jedes Wort in einem Satz generieren?
Erfordert die per-Wort-Lesedaten Webcam-Augenverfolgung?
Kann ich mehr als einen Satz in einem einzigen Rahmen zeigen?
Kann ich meine eigene Stimulus-Tabelle hochladen?
Weiterführende Literatur
Webcam-Augenverfolgung
Die peer-reviewte Blickengine hinter den per-Wort-Metriken der Textsegmentierung.
Mausverfolgung
Verfolgen Sie die Cursorposition und -trajektorie als ein weiteres Verhaltensmaß neben dem Blick.
Funktionsübersicht
Die vollständige Palette von Technologie-Fähigkeiten, die auf der Labvanced-Plattform verfügbar sind.