发送到OpenAI动作
概述
Send to OpenAI 动作允许您将信息,例如字符串输入值,发送到OpenAI。您可以指定某个 Model Type 以在文本、图像或音频生成的上下文中接收提示。
注意: 为了使用此选项,您必须首先在 Settings 选项卡下列出您的API密钥。
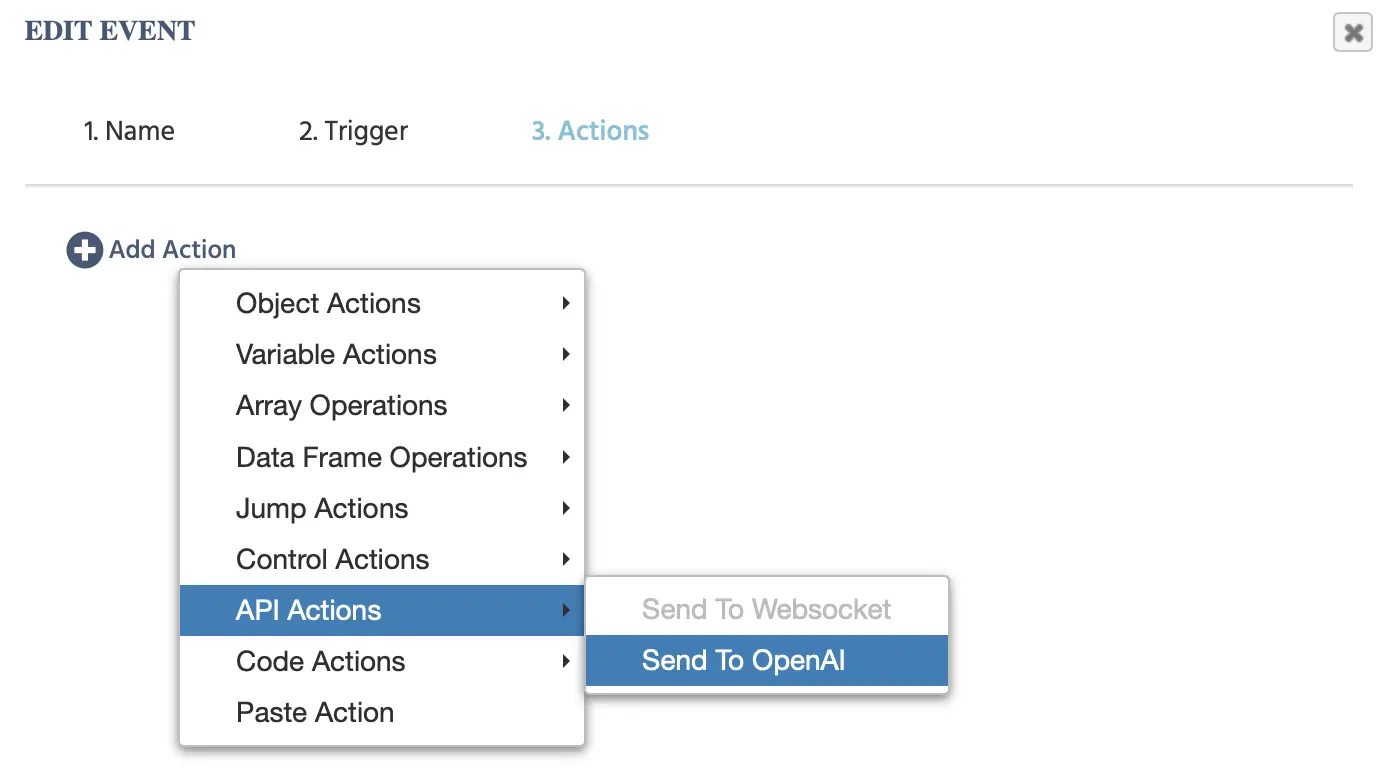
点击此事件后将出现以下选项:
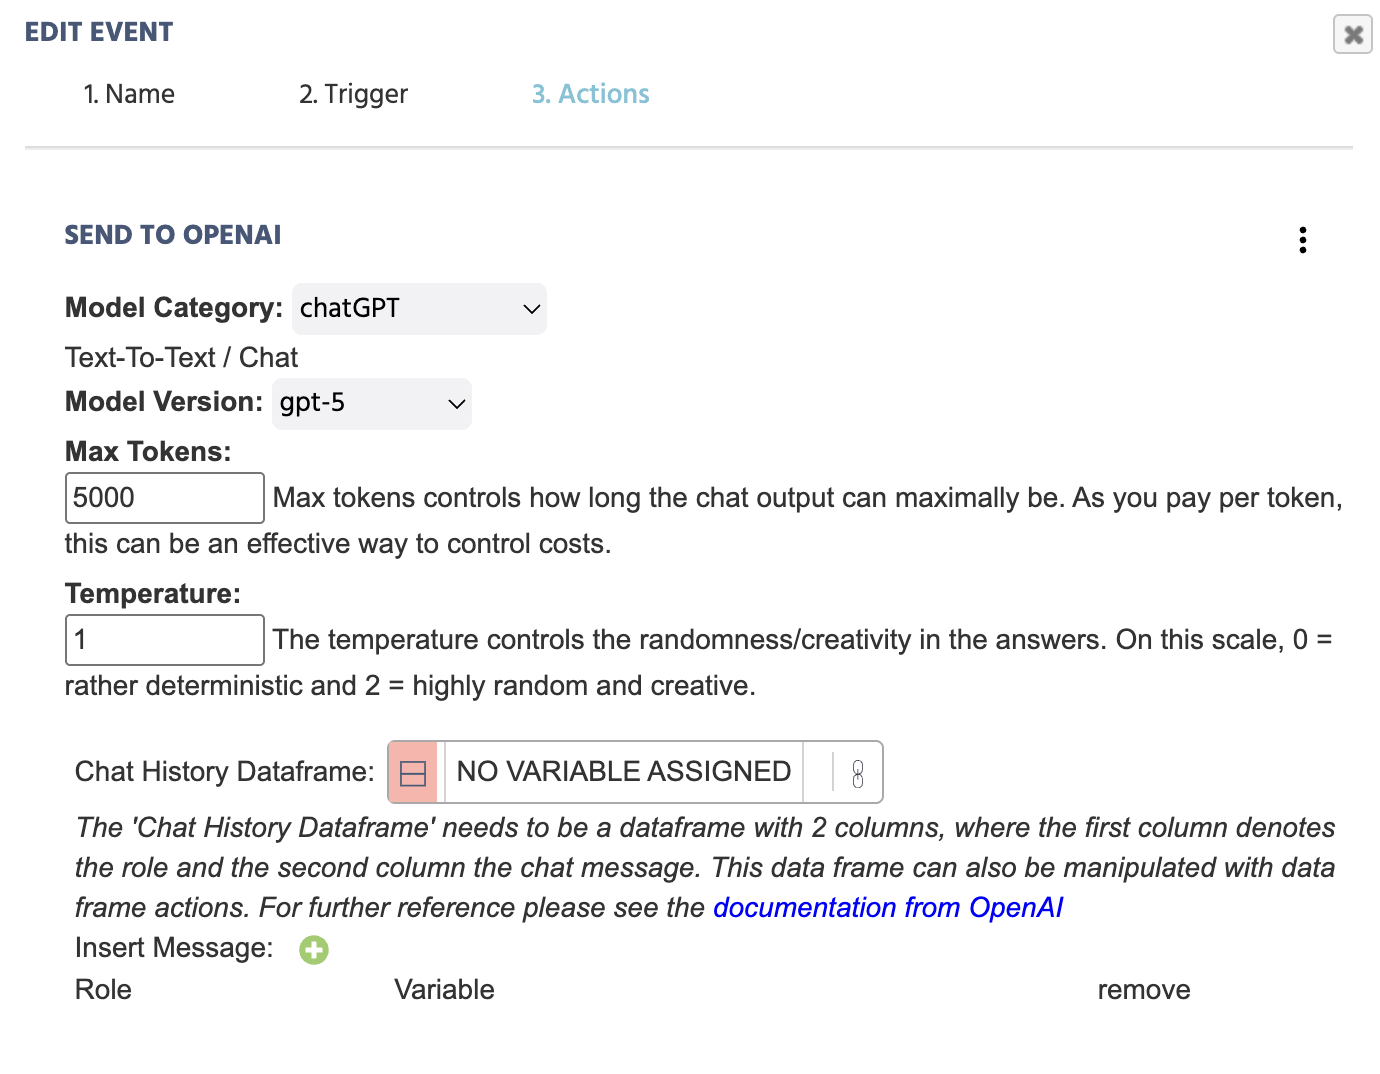
根据所选的 Model Category,
模型类别
| 模型类别 | 描述 |
|---|---|
ChatGPT | 将文本输入发送到OpenAI以生成基于文本的响应。 |
Image Generation | 将文本输入发送到OpenAI以生成图像。 |
Generate Audio | 将文本输入发送到OpenAI以生成音频。 |
ChatGPT - 模型类别
这是在提供所有必要信息时此事件的功能示例:
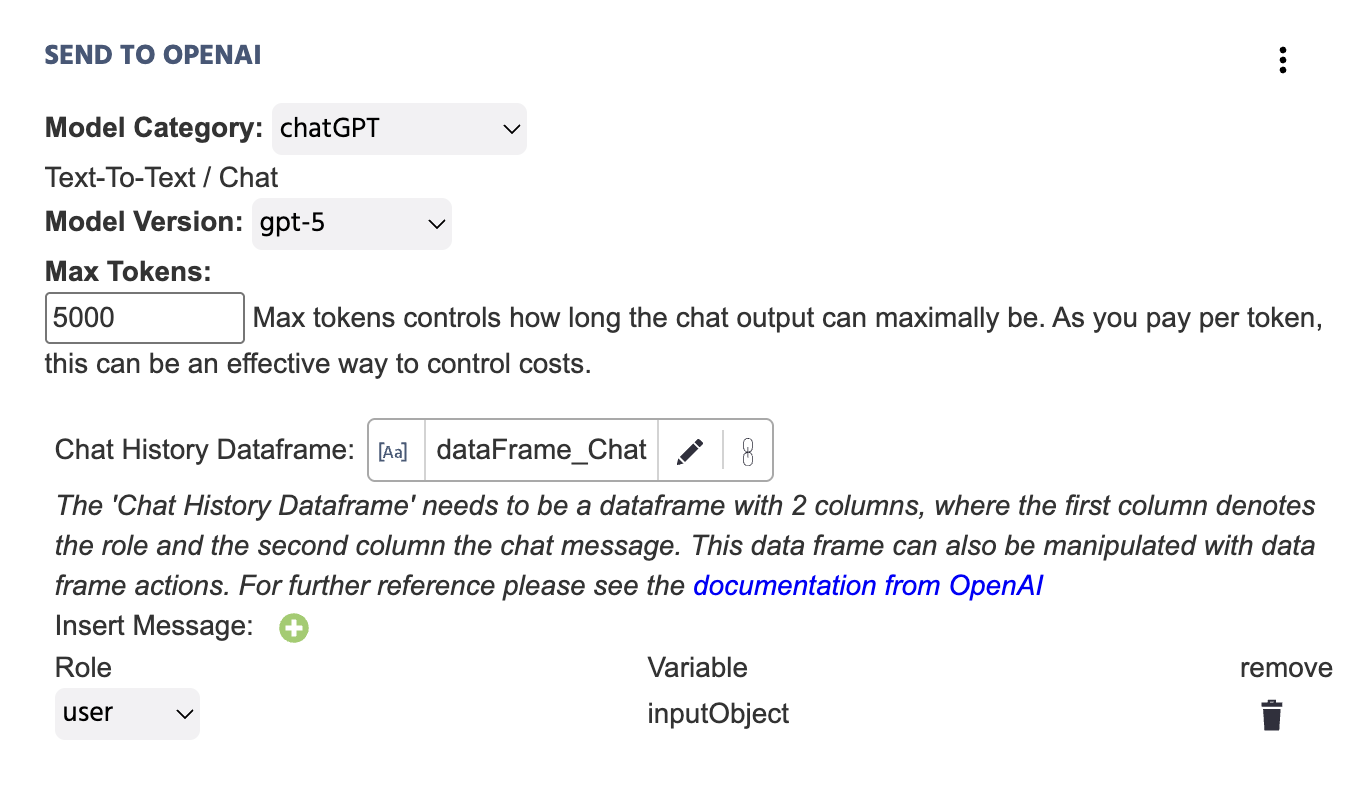
以下是对在 Send to OpenAI 动作下包含的字段的更深入解释,ChatGPT 被选为 Model Category:
| 菜单项 | '发送到OpenAI'动作选项 - ChatGPT |
|---|---|
Model Category | 指定与特定动作相关的AI模型类别。在这种情况下,选择 ChatGPT 适用于文本到文本场景。有关其他选项,例如图像或音频生成,请参阅下面的部分。 |
Model Version | 指定在实验中应调用的ChatGPT版本。可用选项范围包括:
|
Max Tokens | 最大令牌控制聊天输出的最大长度。由于按令牌收费,这可以是控制成本的有效方法。 |
Temperature | 温度控制答案的随机性/创造性。在该尺度上,0 = 相当确定,2 = 高度随机和创造性。 |
Chat History Dataframe | 链接到具有两列的数据框变量。第一列表示“角色”,第二列表示“聊天消息”。来自该动作的值将自动附加到此处链接的数据框中。 数据框还可以通过数据框操作进行操作。有关更多参考,请查看 OpenAI的文档。 |
Insert Message ‘+’ | 点击此项后,将出现变量对话框。您需要指示将“变量”值发送到OpenAI以及相关消息的“角色”:
|
注意1: 另请参阅 此指南,在其中我们逐步构建研究,集成ChatGPT并利用此动作。
图像生成 - 模型类别
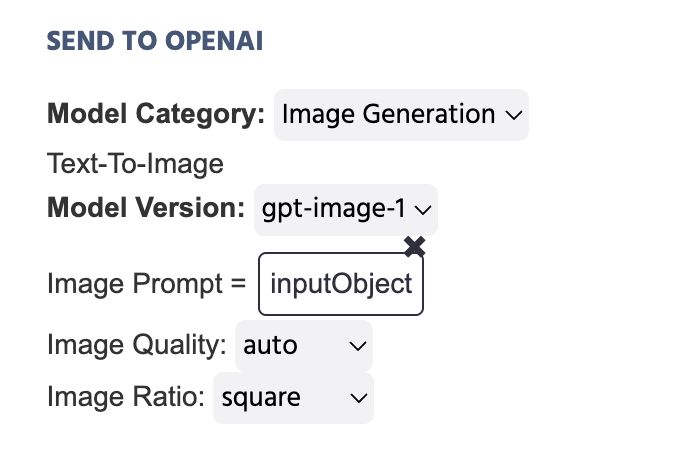
在下面的示例中,用于存储在 Input Object 中写入文本的变量将作为 Image Prompt 发送到OpenAI,以作为此动作的结果:
有用的演示: 请查看 此演示,利用OpenAI触发器和动作进行图像生成。参与者被要求输入提示,然后该提示用于生成图像。
以下是对在 Send to OpenAI 动作下包含的字段的更深入解释,Image Generation 被选为 Model Category:
| 菜单项 | '发送到OpenAI'动作选项 - Image Generation |
|---|---|
Model Category | 指定与特定动作相关的AI模型类别。在这种情况下,选择 Image Generation 适用于文本到图像场景。有关其他选项,例如图像或音频生成,请参阅下面的部分。 |
Model Version | 指定在实验中应调用的ChatGPT版本。可用选项包括:
|
Image Prompt | 提供您设置应生成的图像提示的选项。常见的方法包括设置 Constant Value,例如一串书面文本,或使用类似 Input Object 的变量并链接到此处。 |
Image Quality | 提示您指示将根据上述文本提示生成的图像质量。选项包括: |
Image Ratio | 提示您指示将生成的图像的比例。 |
Image Style | 如果选择 DALL-E-3 作为 Model Version,则该选项会出现以指定图像样式。选项包括:自然和生动。 |
生成音频 - 模型类别
在下面的示例中,用于存储在 Input Object 中写入的文本的变量将作为 Prompt 发送到OpenAI,以作为此动作的结果:
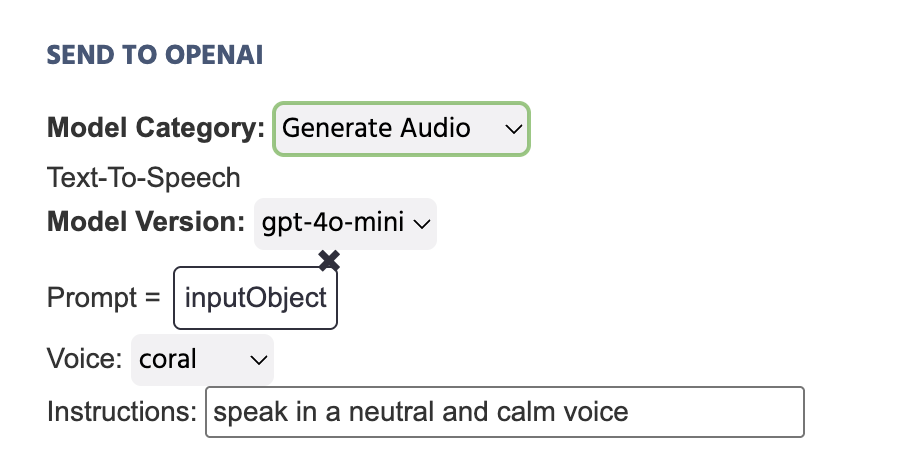
以下是对在 Send to OpenAI 动作下包含的字段的更深入解释,Generate Audio 被选为 Model Category:
| 菜单项 | '发送到OpenAI'动作选项 - Generate Audio |
|---|---|
Model Category | 指定与特定动作相关的AI模型类别。在这种情况下,选择 Generate Audio 适用于文本到音频场景。有关其他选项,例如图像或音频生成,请参阅下面的部分。 |
Model Version | 指定在实验中应调用的ChatGPT版本。可用选项包括:
|
Prompt | 提供您设置应生成的音频提示的选项。常见的方法包括设置 Constant Value,例如一串书面文本,或使用类似 Input Object 的变量并链接到此处。 |
Voice | 设置应采用的生成音频的语调。可用选项包括:
|
Instructions | 输入进一步的指示,以使生成的音频形成,例如“用中立和平静的声音说话......” |
有用的演示: 请查看 此演示,利用OpenAI触发器和动作进行音频生成。生成的文本通过OpenAI生成,并在与参与者朗读段落的上下文中使用,参与者必须回答多项选择题。
重要说明
- 由于OpenAI每天都在发展,请查看 OpenAI的文档 以获得有关聊天的进一步说明,并考虑浏览其他模型类别的文档,例如文本到音频。