Variables de Data Frame
Une variable de data frame contient des données tabulaires dans une structure similaire à une feuille de calcul : les lignes sont des entrées et les colonnes sont des variables, chacune pouvant contenir des valeurs de type chaîne, numérique, booléenne ou fichier. Les data frames ne sont pas peuplés par les réponses des participants. Vous téléchargez un fichier .csv pour y charger des données, et l'expérience les lit en temps réel à l'aide du système d'événements.
Les data frames sont l'outil standard dans Labvanced pour gérer des entrées structurées : listes de stimuli, plannings de contrebalancement, mappages de fichiers à images, et tout autre scénario où vous devez intégrer des lignes de données préparées dans votre expérience un essai à la fois.
Quand utiliser un data frame
Utilisez un data frame chaque fois que votre expérience doit charger des données structurées préparées au lieu de collecter des valeurs des participants.
- Vous avez une liste de mots stimulus, phrases, images ou fichiers audio qui doivent apparaître essai par essai
- Vous devez contrebalancer les conditions entre les participants
- Vous souhaitez mélanger l'ordre des essais au début d'une expérience et ensuite lire les entrées de manière séquentielle
- Vous chargez des invites OpenAI, des messages personnalisés, ou d'autres données de chaîne à partir d'un fichier préparé
Configuration d'un data frame
Créer un data frame prend trois étapes : préparer votre CSV, créer la variable, et importer le fichier.
Formatage de votre CSV
Chaque colonne de votre CSV devient une variable (colonne) dans le data frame. Chaque ligne est une entrée. Si votre première ligne contient des noms de colonnes, activez Use first row as header lors de l'importation.
Pour les stimuli basés sur des fichiers (images, audio), mettez les noms de fichiers dans la colonne pertinente. Vous pouvez ensuite utiliser Map strings to files lors de l'importation pour lier ces noms aux fichiers téléchargés dans votre étude.
Création de la variable de data frame
- Ouvrez votre étude et allez à l'onglet Variables dans le panneau gauche, ou ouvrez l'onglet
Variablesdans l'éditeur de tâches. - Cliquez sur
+ New Variableet définissez leData TypesurData Frame. - Cliquez sur
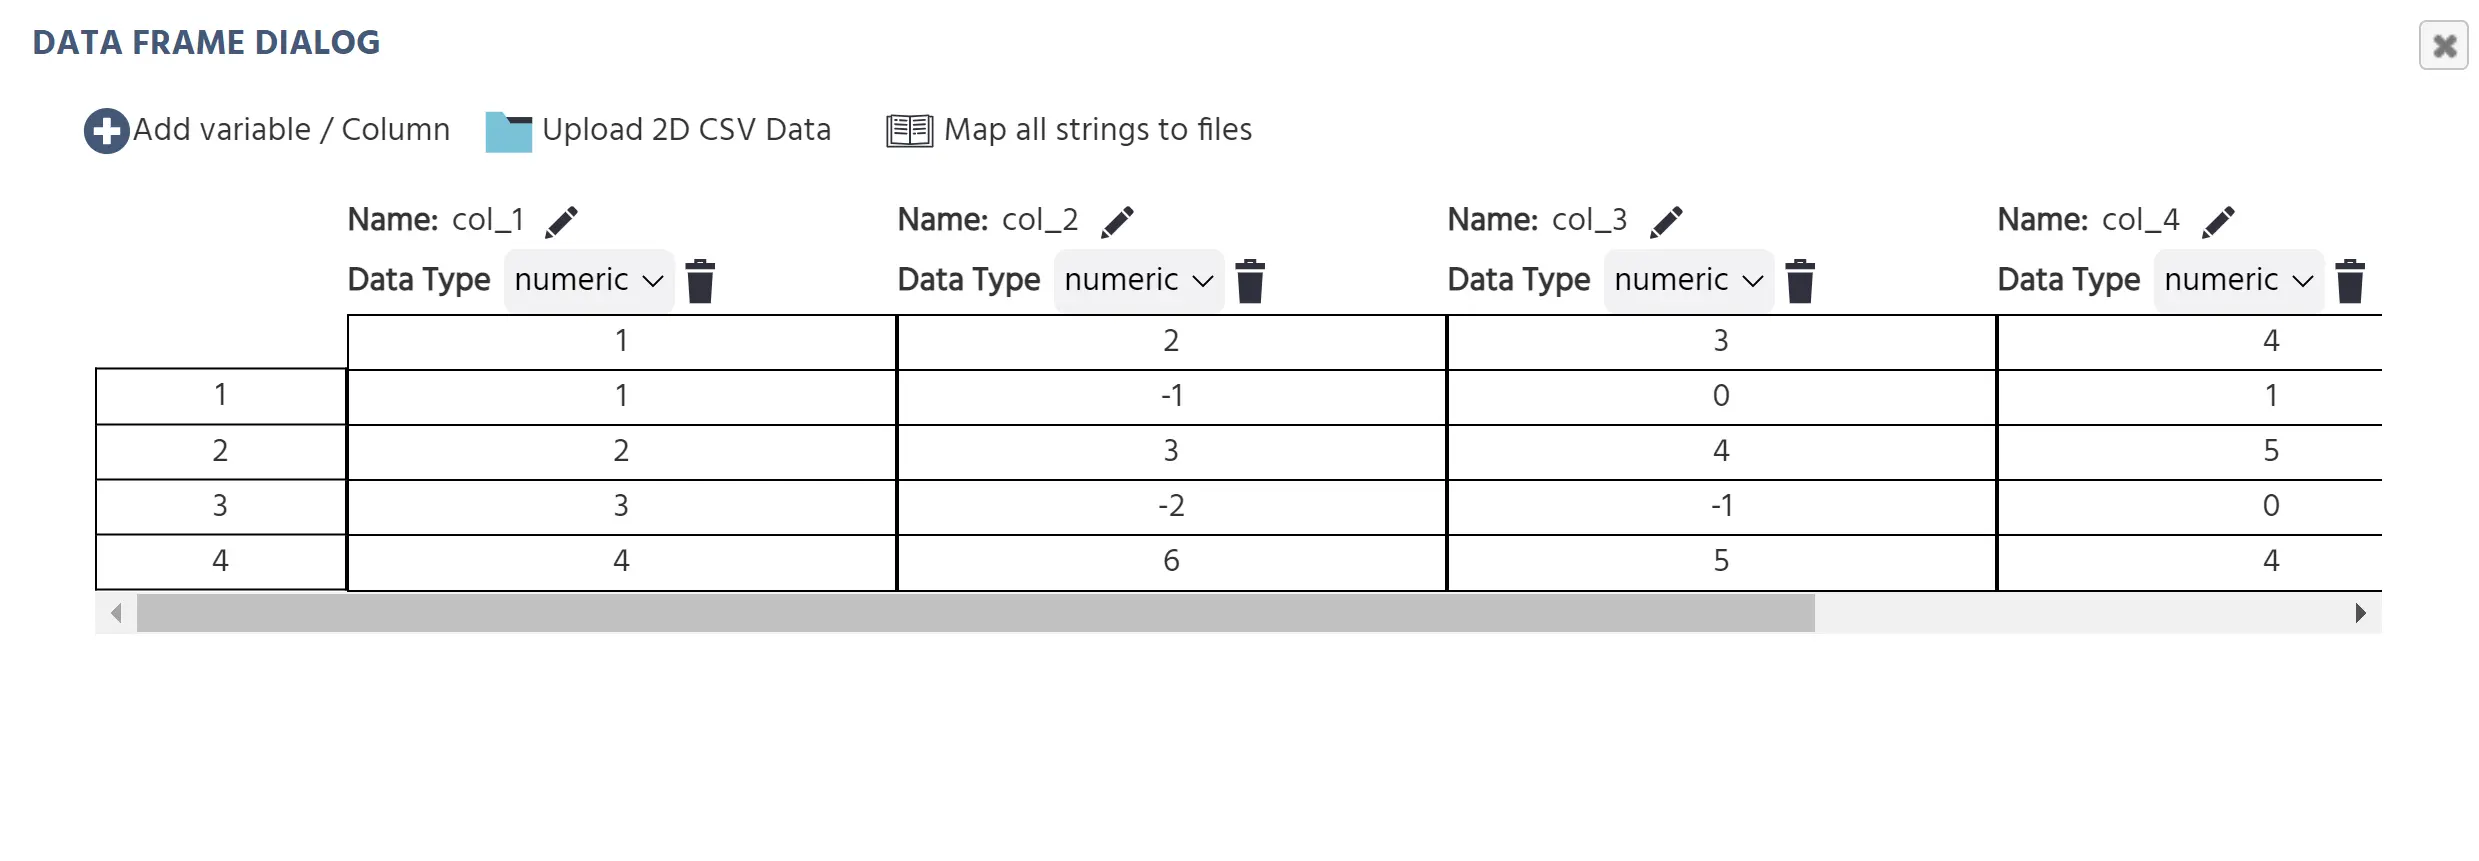
Save. La boîte de dialogue Data Frame s'ouvre.
Téléchargement de votre CSV
Dans la boîte de dialogue Data Frame, cliquez sur Upload 2D CSV Data. Un sélecteur de fichiers s'ouvre. Après avoir sélectionné votre fichier, la boîte de dialogue Options d'importation apparaît.
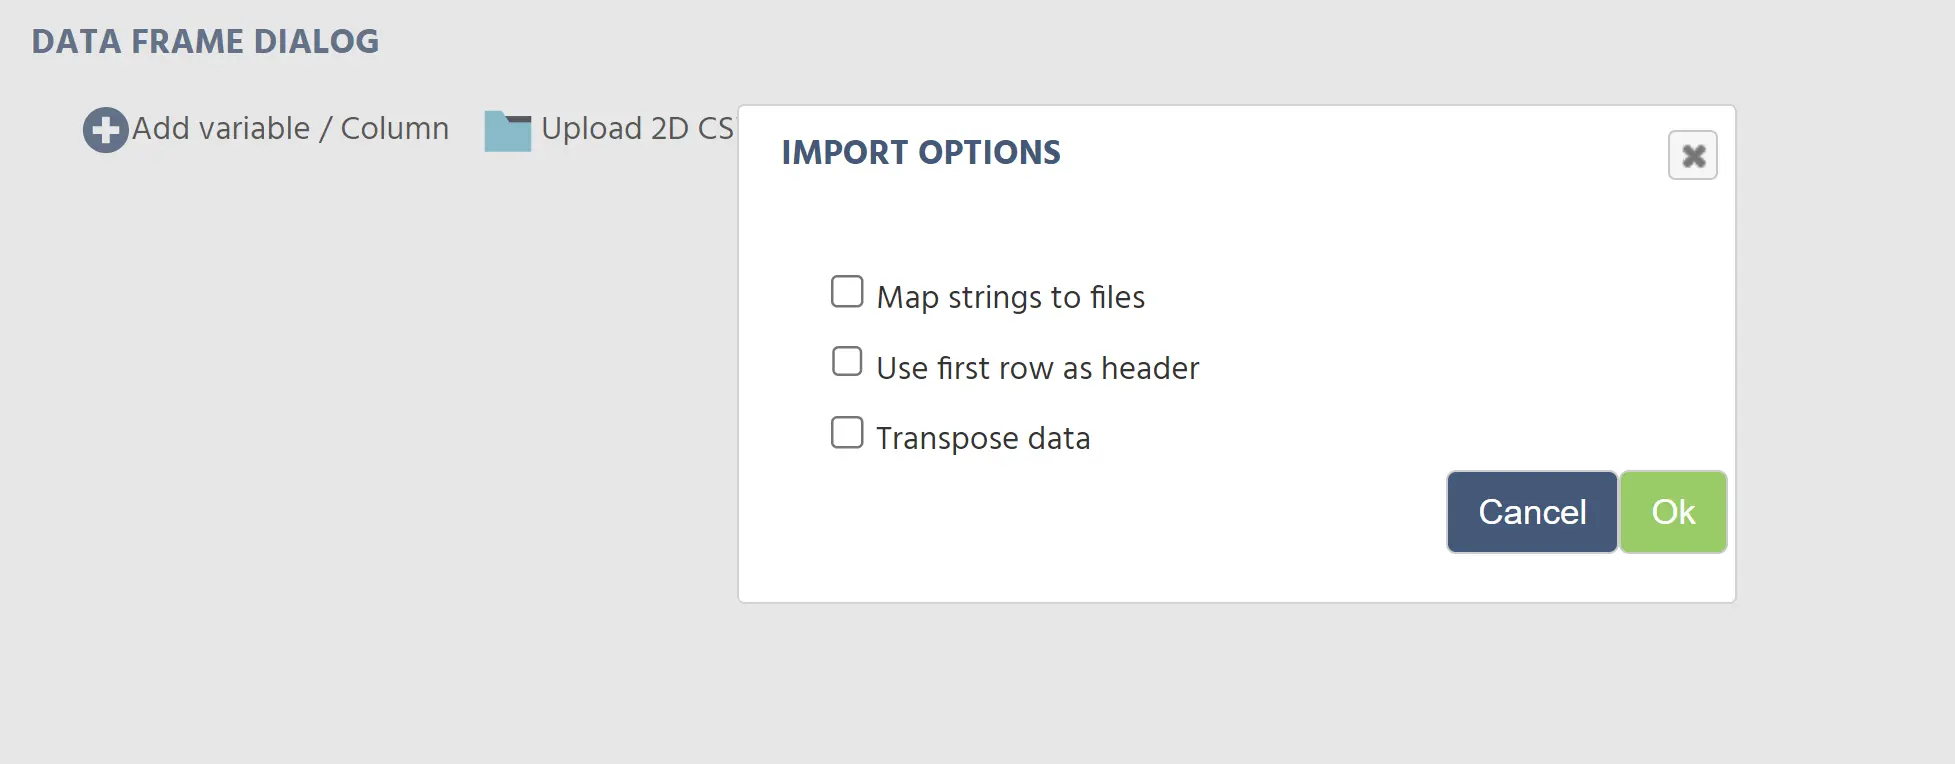
| Option | Ce qu'elle fait |
|---|---|
Map strings to files | Traite les valeurs de chaîne dans le CSV comme des noms de fichiers et les lie aux fichiers téléchargés dans votre étude |
Use first row as header | Utilise la première ligne de votre CSV comme noms de colonnes plutôt que comme données |
Transpose data | Télécharge les données sans transposer les lignes et les colonnes |
Cliquez sur Ok pour importer. Le data frame est peuplé avec le contenu de votre CSV.
Édition d'un data frame
Une fois qu'un data frame est créé, vous pouvez l'étendre avec de nouvelles colonnes, modifier directement les valeurs des cellules individuelles, ou remplacer tous les contenus par un nouvel import CSV.
Ajout de colonnes
Pour ajouter une nouvelle colonne après l'importation initiale, cliquez sur Add variable / Column en haut de la boîte de dialogue Data Frame. Cela ajoute une colonne vide que vous pouvez nommer et configurer. Si la nouvelle colonne contient des noms de fichiers, cliquez sur Map all strings to files dans la boîte de dialogue par la suite pour les lier aux fichiers téléchargés dans votre étude.
Édition des valeurs des cellules
Pour éditer directement les valeurs des cellules individuelles, activez la case Edit Values dans la boîte de dialogue Data Frame. Les cellules deviennent modifiables sur place. Désactivez la case pour revenir à la vue en lecture seule.
Utilisation des data frames dans le système d'événements
Les data frames sont lus et écrits via le système d'événements. Deux actions dans la catégorie Opérations sur les Data Frames gèrent cela.
Lire / Écrire dans une Action de Data Frame
Utilisez cette action pour lire une ligne ou une colonne du data frame dans une variable de tableau, ou pour écrire des valeurs en retour.
Paramètres clés :
| Paramètre | Description |
|---|---|
| Variable de data frame | Le data frame à partir duquel lire ou écrire |
| Lire ou Écrire | Direction de l'opération |
| Par ligne ou colonne | Que ce soit pour lire une ligne complète ou une colonne complète |
| Type d'index | Comment la ligne ou la colonne est sélectionnée : valeur fixe, variable, ou dernière ligne |
| Variable d'index | La variable utilisée comme index lorsque le type d'index est défini sur variable |
| Variable de sortie | La variable de tableau où le résultat est stocké |
Le modèle le plus courant est : maintenir une variable de compteur numérique qui s'incrémente à chaque essai, l'utiliser comme variable d'index, et lire la ligne correspondante dans un tableau. Chaque élément du tableau correspond alors à une colonne de cette ligne.
Action Mélanger les Entrées de Data Frame
Utilisez cette action pour randomiser l'ordre des lignes ou des colonnes dans le data frame. Exécutez-la une fois au début de l'expérience (déclenchée par un événement de début de session) avant que les essais ne commencent.
Paramètres :
| Paramètre | Description |
|---|---|
| Data frame | Le data frame à mélanger |
| Par lignes ou colonnes | Que ce soit pour mélanger l'ordre des lignes ou des colonnes |
Un flux de travail commun : liste de stimuli par essai
Une configuration typique pour lire une ligne de stimuli par essai :
- Téléchargez un CSV avec une ligne par essai et des colonnes pour chaque attribut de stimulus (par exemple,
word,condition,correct_response). - Créez une variable numérique
trial_indexavec une valeur de départ de1etReset at Trial Startdésactivée. - Au début de l'expérience, ajoutez une action
Shuffle Data Frame Entriessur votre data frame (par lignes). - Au début de chaque essai, ajoutez une action
Read from / Write to Data Frame: lire par ligne, Variable d'index =trial_index, Variable de sortie = une variable tableau (par exemple,current_trial_data). - Après la lecture, incrémentez
trial_indexde1à l'aide d'une action arithmétiqueSet / Record Variable. - Utilisez les éléments de la variable tableau pour définir les propriétés des objets ou pour conduire la logique des événements pour cet essai.
Lectures supplémentaires
Opérations sur les Data Frames
Les actions du système d'événements pour lire, écrire et mélanger les data frames en temps réel.
Types de Variables
Une référence pour tous les six types de variables et quand les utiliser.
Propriétés des Variables
Une référence complète pour chaque paramètre de variable : type de données, échelle, format, valeur de départ, comportement de réinitialisation, et options d'enregistrement.
Modèles de Data Frame
Comment appliquer les data frames à des conceptions de recherche courantes : présentation séquentielle de stimuli, contrebalancement, et stimuli basés sur des fichiers.
Randomisation et Contrebalancement
Comment utiliser les data frames, le système d'essai, et les événements pour contrebalancer et randomiser votre étude.
Travailler avec des Variables
La page centrale pour la section travailler avec des variables : types, propriétés, options d'enregistrement, et data frames.