AI共犯者: 方法論と妥当性
AI共犯者は、欺瞞、社会的圧力、交渉パラダイムにおいて人間の共犯者の代わりを務めるスクリプトやモデル駆動のエージェントです。訓練された人間の共犯者とは異なり、その行動はすべての参加者にわたって正確に指定、記録、再現することができ、これが使用するための中心的な方法論的議論であり、また、デフォルトで使用するのではなくデザイン決定として評価されるべき理由です。
このページでは、AIを従来の古典的パラダイムの中で人間の役割を果たすツールとして扱っています: AIは手段であって、測定されるものではありません。これは、AI自体が研究対象となる研究とは異なる問題です。後述のFAQで取り上げられています。
AI共犯者と見なされるもの
共犯者とは、古典的な意味では、参加者には別の参加者や普通の相手として現れるが、実際には実験者が制御するスクリプトに基づいて行動している人のことを指します。これは、欺瞞パラダイム(コンフォーミティ研究の偽共同参加者)、社会的圧力パラダイム(信頼ゲームで協力的に行動しないパートナー)、交渉またはバイイング作業(予め決められたパターンに従ったオファーをする対戦相手)などでよく知られています。AI共犯者は、その人間の共犯者をモデル駆動のエージェントで代替します: 参加者は、研究内の別の当事者と相互作用していると信じ続けるか、そう信じさせられますが、その当事者の応答は、訓練された人間の演者によって行われるのではなく、AIシステムを通して生成またはスクリプト化されるものです。
これは新しい実験デザインではありません。既に存在するデザインの中での代替アプローチであり、実際のフィールドには同じアイデアの低テク版があります: Labvancedのマルチユーザー研究のドキュメントは「仮想対戦相手」戦略を説明しており、参加者は他の参加者と対戦していると伝えられますが、実際にはランダムに選択するアルゴリズムが存在しています。このアプローチはAI共犯者のアイデアの真の祖先ですが、限界もあります: ランダム選択アルゴリズムはスクリプト化された社会的圧力の交換を維持したり、交渉したり、信じられる欺瞞的な会話を続行したりすることはできません。生成的AIが加えるのは、自然で状況に応じた言語を生成する能力であり、いくつかのデザインでは人間の共犯者のライブインプロビゼーションの代わりに音声や画像を生成できるため、これはランダム選択アルゴリズムではサポートできないパラダイムに特に適しているのです。
AI共犯者の必要性
AI共犯者は人間の共犯者の完全な置き換えではなく、他の実行可能なオプションであり、いくつかのデザインではより強力な選択肢です。それを支持する4つの考慮事項があります: 制御、再現性、倫理、スケール。
制御
訓練された人間の共犯者は、すべての参加者にわたって固定された行動プロトコルを再現するよう求められます: 同じトーン、同じ反発、交渉タスクにおける譲歩の同じタイミングです。実際には、共犯者は漂流します。疲労、気分、そして多くのセッションを運営してきた経験がすべて、研究者が設計していない変動を引き起こし、その変動は時間やセッションの順序と相関するため、混乱要因となります。固定されたプロンプトと固定された設定から生成されるAIエージェントは、人間とは異なり、疲労やセッション経験の蓄積を持たないため、その特定のセッション間の漂流を取り除きますが、独自の一貫性の要件は生じます(以下参照)。
Labvancedの実装では: 同じSend to OpenAI設定がすべてのセッションで変更されることなく実行されます。これは固定設定であり、人間が毎回記憶から再現しなければならないプロトコルではありません。
再現性
人間の共犯者の正確な行動は、方法セクションではほとんど完全に仕様されていません。詳細なスクリプトであっても、人間の演者が判断で埋めるギャップがあるため、他の研究室が研究を再現しようとすると、元の共犯者のパフォーマンスの近似を再現していることになります。文書化されたプロンプト、モデルバージョン、生成パラメータは完全で持ち運び可能な仕様です: 他の研究室は、新しい演者を訓練して元の共犯者の行動を近似させるのではなく、同一の設定を実行できるのです。
Labvancedの実装では: モデルバージョン、温度、そしてプロンプト自体がタスク設定に直接保存されるため、このセクションで求められる完全な仕様は追加の文書作業ではなく、すでに保存されているものです。
倫理
参加者をライブの人間の共犯者で欺くことは、ほとんどの機関レビュー・プロセスが研究者に正当化とデブリーフィングを要求する倫理的な重みを持ちます: 実際の人間が何らかの形で欺瞞に関与していたのです。AI生成の共犯者は、その配置の倫理的な性質を変えますが、研究デザイン自体の根本的な欺瞞は取り除かれず、それは他の欺瞞パラダイムが必要とするのと同様に、同じデブリーフィングと同意の処理を必要とします。これにより、共犯者の使用に関する特定の倫理的次元が和らぎますが、全体的に欺瞞パラダイムが倫理的に簡素化されるわけではありません。
スケール
オンラインおよびリモート研究は、単一の研究室セッションができるよりもはるかに多くの参加者を募集できますが、それは人間の共犯者に固有のスケーリング問題を生じさせます: 追加の参加者はすべて別の共犯者セッションを必要としますので、より大きなサンプルは、より多くの共犯者を募集、訓練、スケジュールする必要があり、さらに、共犯者間の行動的一貫性を維持する必要があります。AI共犯者にはこの問題はありません。千人目の参加者は最初の参加者と全く同じ設定で実行され、追加のスタッフ、訓練、または共犯者間の一貫性チェックを管理する必要はありません。これが、AI共犯者が大規模なオンライン研究に特に適している理由です。
Labvancedの実装では: 研究が20人の参加者を集めるか2,000人を集めるかにかかわらず、同じAI協力者の設定が変更されずに動作します。これは、タスク設定であって、サンプルサイズに応じてスケールする必要があるのは人員配置ではないからです。
AI協力者を使用する際の方法論的考慮事項
AI協力者を採用することは、プラグアンドプレイの選択ではありません。独自の設計要件を導入し、それをスキップすることは、ヒューマン・コホートの混乱をモデル・コホートの混乱と交換するだけです。
AIの行動を独立変数として制御する
AI協力者の反応が参加者間で予測不可能に異なる場合、トーンや協力的または非協力的に見えるかどうか、反応の長さなど、研究はAI協力者が除去することを目的としたまさにその種類の制御されていない変動を再導入したことになります。LabvancedのAIと心理学研究の統合は、研究者が協力者の行動を仮定ではなく制御変数として扱うために必要な特定のパラメータを明らかにします。
- 研究の期間中に固定された
Model Version、これによりセッション間のプロバイダー側モデルの更新が研究中に協力者の行動を変更することはできません。 - 協力者のペルソナと行動の境界をモデルのデフォルトの判断に任せるのではなく、文書として定めた詳細な
system-ロールメッセージ、Insert Messageを介して設定され、参加者プールに合う言語レジスタやスラング、最新の出来事に対する意識がどこまで及ぶべきか、参加者が直接「あなたはAIですか?」と尋ねた場合にどのように応答するかを示します。 - スクリプト的な感覚を持った協力者のために、
Temperatureは範囲の決定論的な端に設定されます。温度は生成された応答がどれだけランダムか予測可能かを支配します。 - 応答の長さを一貫して保つために
Max Tokensは制限され、制限のない協力者は、一つのセッションから次のセッションにかけて言う内容が大きく異なる可能性があります。 - 音声ベースの協力者には、固定された
Voiceと書面でのInstructions(例えば、中立的で冷静な配信を指定する)により、参加者間での声のトーンを一定に保つ必要があります。 - すべての参加者との完全なやり取りが記録されており、協力者が一貫して行動したことを事後検証するために利用できるようにリンクされた
Chat History Dataframe。これは、ヒューマン協力者のスクリプト遵守に対する操作チェックが提供する監査トレイルと同じです。
これらの設定は、セッション間のgenAIパフォーマンスの一貫性を確保するのに役立ちます。これらは研究者が意図的に引かなければならないレバーであり、ヒューマン協力者研究がトレーニングプロトコルとセッション間の忠実度チェックを必要とするのと同じように、俳優がスクリプトを無助で再現するだろうと仮定してはいけません。
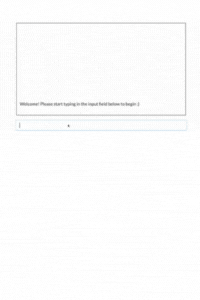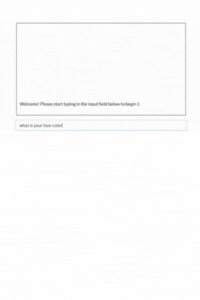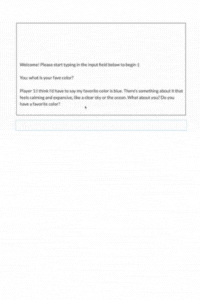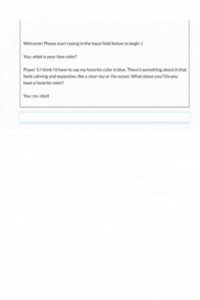
このテンプレートは、LabvancedとOpenAI間のリアルタイム通信チャネルを設定します。この統合に基づいて構築された協力者ベースの研究の基盤です。これを出発点として、プロンプト、モデル、パラメータを調整してあなたのパラダイムに合わせてください。
注意: この特定のデモでは、トークンの長さ(つまり、応答の長さ)は100に設定され、温度(つまり、創造性)は1に設定されています。これは研究設定の下で調整できます。
有効性変数としてのプロンプトデザイン
system-ロールメッセージは、研究者が協力者の全行動方針を手動で記述する場所です:その言語レジスタとスラング、最新の出来事に対する意識がどこまで及ぶべきか、そして参加者が「あなたはAIですか?」と直接聞く場合にどのように応答するか。異なるスラングのキャリブレーション、異なる最新イベントのカットオフ、またはAIに関する質問への異なるスクリプト回答を持つ同じ代替を実行する二つの研究室は、意味のある異なる協力者の行動を得る可能性があり、これは通常の言語モデル研究で文書化されているプロンプト感度の一形態です (Zhuo et al., 2024)。AI協力者に対する参加者の応答がヒューマン協力者に対する応答と異なるという研究は、真の代替効果を捉えている可能性がありますが、これらの次元の一つにおいて不十分に指定されたまたは不適切に設計されたプロンプトを拾う可能性もあります。プロンプトデザインを報告され、精査されるべき変数として扱うことが、これら二つの説明を区別可能にするものです。
Labvancedの実装では: これはsystem-ロールメッセージがInsert Messageを介して設定され、各セッションごとに新しく入力するのではなく、タスクの一部として一度保存されるため、正確に書かれた通りに報告および監査することが可能になります。
同じ著作権も意図的な使用を開きます。研究者は、条件間でシステムプロンプトを操作変数そのものとして変化させることができます。たとえば、交渉タスクでの協力的ペルソナの協力者対競争的ペルソナの協力者です。ここではプロンプト自体が独立変数であり、条件間で意図的に変化させられ、一方で方法論的な基準がそれに応じてシフトします。プロンプトの変種は、意図された次元(協力的対競争的)に沿って異なる必要があり、他の次元(長さ、形式、語彙)に沿って偶然的に異なってはいけません。さもなければ、操作は研究が始まる前に混乱します。参加者が実際に協力者を意図された次元に沿ってどのように認識したかに関する操作チェックがここでは不可欠になります。これは、パイロットテストがヒューマン協力者のスクリプトペルソナが意図通りに伝わったことを確認するのと同じです。
パラダイム適合
AI協力者は、相互作用を事前に指定できるか、限定されたタイプの応答から生成できるパラダイムに適します。詐欺シナリオ、構造化された社会的圧力交換、定義されたオファースペースを持つ交渉や取引のタスクです。AI交渉研究はここでの最も明確な適合の一つです。なぜなら、オファーとカウンターオファーは定義された空間内に落ちるため、オープンエンドの即興演奏を必要としないからです。協力者がその限られた空間の外で説得力を持って即興演奏する場合や、参加者が同じ地位の人間の仲間と対処していると信じることが詐欺の依存である場合には、AIを扱うことはあまり適していません。
Labvancedの実装では: Send to OpenAIアクションは、単独参加者研究内での詐欺、社会圧力、または交渉交換の協力者側を生成します。協力者は別のリアルな接続されたユーザーではないため、これらのパラダイムを構築するのにLabvancedのマルチユーザーインフラストラクチャは必要ありません。参加者のセッションが唯一のライブセッションです。
| パラダイムタイプ | AI共謀者の適合性 | 理由 |
|---|---|---|
| スクリプトによる欺瞞(偽の共同参加者、確認操作) | よく適合 | 行動は事前に完全に指定可能;ライブの即興は不要 |
| 構造化された社会的プレッシャーの交換(信頼ゲームやジレンマゲームにおけるパートナーの協力/裏切り) | よく適合 | 反応空間は制約されている(協力、裏切り、特定のメッセージタイプ)、制御されたプロンプトに適している |
| 定義されたオファー空間を持つ交渉や取引タスク | よく適合 | 提案と対案は文書化されたパラメーター内で生成可能 |
| オープンエンドな即興の社会的インタラクション | 適合しない | 限定された反応セットの外での、説得力のある即興的な人間のような即興に依存 |
| 同等の地位を持つ人間の仲間の信念が操作の荷重要素であるデザイン | まず操作チェックが必要 | AIの存在が疑われると、欺瞞が崩壊する;それが成立するかどうかはオープンな経験的質問であり、確定的ではない |
オープンな妥当性の問題
AI駆動の共謀者に欺かれた参加者が、信頼ゲーム、遵守パラダイム、または交渉タスクにおいて人間の共謀者に欺かれた参加者と同じように行動するかどうかは、まだ直接的にテストされていない:この代替は十分新しいため、この対決比較は単にまだ実施されていない。AIの存在を疑ったり発見したりすることが、人間の共謀者にはない形での相互作用の社会的賭けを変える可能性があり、これはAI共謀者が単に交絡を除去するのではなく、人間の一貫性の交絡を異なるAI特有の交絡に置き換えることを意味する。AI共謀者の厳密な使用は、参加者が人間と相互作用していると正しく信じているかどうかを確認する操作チェックを通じて確認すべきオープンな経験的質問として扱われる。
よくある質問
さらなる読書
AIと心理学研究
プラットフォームの能力:実験の流れの中に直接埋め込まれたネイティブのOpenAIテキスト、画像、音声生成。
OpenAIアクションに送信
実装ガイド:制御されたAI共謀者を設定するために使用されるアクションとパラメーター(モデルのバージョン、温度、声、指示)。
二人またはグループの相互作用デザインに取り組んでいて、より広い文脈が必要ですか? 心理学研究における二者効果は、もう一方の当事者の存在がペアデザインにおいて個々の行動をどのように変えるかについて説明しており、人間またはAIの共謀者が活動する同じ領域にあります。単純なペア以上のものが関与するところでは、関連するパターンが現れ、チームダイナミクス研究で扱われています。
交渉または取引のパラダイムがターゲットデザインである場合、ウルティマタムゲームタスクページは、AI共謀者が生成するのに非常に適した制約のあるオファー空間構造の具体例です。