labvanced logoLabVanced
  • Research
    • Publications
    • Researcher Interviews
    • Use Cases
      • Developmental Psychology
      • Linguistics
      • Clinical & Digital Health
      • Educational Psychology
      • Cognitive & Neuro
      • Social & Personality
      • Arts Research
      • Sports & Movement
      • Marketing & Consumer Behavior
      • Economics
      • HCI / UX
      • Commercial / Industry Use
    • Labvanced Blog
    • Services
  • Technology
    • Feature Overview
    • Code-Free Study Building
    • Eye Tracking
    • Mouse Tracking
    • Generative AI Integration
    • Multi User Studies
    • More ...
      • Reaction Time/Precise Timing
      • Text Transcription
      • Heart Rate Detection (rPPG)
      • Emotion Detection
      • Questionnaires/Surveys
      • Experimental Control
      • Data Privacy & Security
      • Desktop App
      • Mobile App
  • Learn
    • Guide
    • Videos
    • Walkthroughs
    • FAQ
    • Release Notes
    • Documents
    • Classroom
  • Experiments
    • Cognitive Tests
    • Sample Studies
    • Public Experiment Library
  • Pricing
    • Licenses
    • Top-Up Recordings
    • Subject Recruitment
    • Study Building
    • Dedicated Support
    • Checkout
  • About
    • About Us
    • Contact
    • Downloads
    • Careers
    • Impressum
    • Disclaimer
    • Privacy & Security
    • Terms & Conditions
    • Third-Party Licenses
  • Appgo to app icon
  • Logingo to app icon
Research
出版物
任务
问卷与量表
方法论
研究者访谈
使用案例
Labvanced 博客
比较
实验室笔记
服务
  • 中國人
  • Deutsch
  • Français
  • Español
  • English
  • 日本語
出版物
任务
问卷与量表
方法论
研究者访谈
使用案例
Labvanced 博客
比较
实验室笔记
服务
  • 中國人
  • Deutsch
  • Français
  • Español
  • English
  • 日本語
  • 出版物
  • 任务
  • 问卷与量表
  • 方法论
  • 研究者访谈
    • 比较在线网络摄像头与实验室眼动跟踪在婴儿音视频同步感知评估中的应用
    • 寻找黄金锁的影响者 - 追随者数量如何推动社交媒体互动
    • 9到36个月大婴儿的语义干扰:一项关于婴儿词汇能力的家庭眼动跟踪研究
    • 歌曲比言语韵律更易记 - 离散音高有助于听觉工作记忆
    • 语法决策任务中的正字法相关性和转置词效应
    • 悲伤诱导后的音乐情绪调节
    • 儿童学习非相邻依赖关系
    • 个性在噪音中听到
    • 所有的眼睛都一样吗?
    • 婴儿中的口头启动
  • 使用案例
    • 研究领域

      • 发展心理学
      • 语言学
      • 临床与数字健康
      • 教育心理学
      • 认知与神经
      • 社会与人格心理学
      • 艺术、音乐与数字媒体
      • 运动与运动心理学
      • 市场与消费者行为
      • 经济学
      • 人机交互 / 用户体验
      • 商业 / 行业使用
    • 研究者

      • 学生
      • 研究人员
      • 小组
  • 博客
    • AI可以预测你将看哪里。它仍然不知道你会做什么。
    • MTurk关闭:招募在线研究参与者的5个替代方案
    • 教育心理学研究中的生成性AI
    • 与婴儿和幼儿进行网络摄像头眼动追踪研究的最佳实践
    • 延迟折扣任务中的刺激类型
    • 延迟折扣任务
    • 基于正念的自我效能量表 - 修订版(MSES-R)
    • 团队动态与研究
    • 斯特鲁普任务 | 历史、任务描述、数据和心理学
    • BKB句子测试 | 程序与研究
    • 心理学中的双人效应 | 概述与研究
    • Navon任务:任务设置、研究及更多
    • 同行评审的网络摄像头眼动追踪
    • Corsi方块敲击测试:从立方体到在线设计
    • 点探测任务 | 完整指南
    • 记忆类型:研究的概念
    • 最后通牒游戏
    • 视觉搜索任务
    • 心理学研究中的注意任务
    • 广泛性焦虑障碍量表-7 (GAD-7)
    • 心理学中的决策任务
    • 强迫症清单 – 修订版 (OCI-R)
    • 评估执行功能技能 | 任务与测试
    • 繁荣量表 (FS) 问卷
    • Labvanced 与开放科学精神
    • 孵化效应的心理学
    • Bouba-Kiki 效应与任务
    • 词汇决策任务:访问心理词汇
    • 图像描述任务和聊天框游戏
    • 平稳的数据收集过程 | 研究的 6 个建议
    • 与 Labvanced 一起进行音乐研究
    • 7 个经典的认知任务及示例
    • 心理旋转测试 | 一种空间处理任务
    • Labvanced 中的 XY 坐标
    • 5 个著名的社会心理学实验
    • 远程和适合婴儿的眼动追踪的力量
    • 威斯康星卡片分类测试 | 历史与研究
    • 13 个用于研究的头部追踪用例
    • 提升感知技能的 5 个建议
    • 优先注视范式介绍
    • 研究偏头痛和头痛患者的认知
    • 着陆页面 - 信息比你想的更多!
    • 耳机检查 - 之前与现在
    • 样本研究 - 实用模板和演示!
    • 什么是神经可塑性?
    • 15 位著名发展理论
    • 视觉注意与眼动追踪
    • 什么是眼动追踪技术?
    • 应用语言学研究中的眼动追踪
    • 10 个流行的语言实验
    • 安慰剂效应
    • 实验设计的六个关键概念
    • 条件性游戏听力测验
    • 艾宾浩斯错觉
  • 比较
  • 实验室笔记
    • 摄像头眼动追踪 2.0
    • 注视检测分析 (敬请期待)
  • 服务
    • 概述
    • 联合资助申请
    • 受试者招募
    • 研究构建
    • 专门支持
    • 许可证比较
图示显示一个 AI 代理和一个人类联合体都输入到同一欺骗、社会压力或谈判范式中

AI 联合体:方法论和有效性

AI 联合体是一个脚本或模型驱动的代理,充当欺骗、社会压力和谈判范式中的人类同伙。与训练有素的人类联合体不同,它的行为可以在每个参与者之间精确指定、记录和再现,这也是使用它的核心方法论论点,同时也是它需要被评估为设计决策而非默认接受的原因。

本页面将 AI 视为在其他经典范式中替代人类角色的工具:AI 是工具,而不是被测量的对象。这与 AI 本身是研究对象的研究问题不同,后者在下面的 FAQ 中有涵盖。


目录

  • 什么算是 AI 联合体
  • AI 联合体的论证
  • 使用 AI 联合体时的方法论考虑
  • 常见问题

什么算是 AI 联合体

在经典意义上,联合体是指对参与者看起来像是另一名参与者或普通互动伙伴,但实际上在按照实验者控制的脚本行事,最常见于欺骗范式(在一致性研究中假装的共同参与者)、社会压力范式(在信任游戏中表现得不合作的伙伴)和谈判或博弈任务(其报价遵循预先设定的模式的对手)。AI 联合体用模型驱动的代理替代该人类同伙:参与者仍然相信,或者被引导相信,他们正在与研究中的另一方互动,但该方的反应是通过一个 AI 系统 生成或脚本化的,而不是由训练有素的人类演员执行。

这并不是一种新实验设计。这是在已经存在的设计中采用的一种替代方法,领域内已经有相同思想的低技术版本:Labvanced 自己的 多用户研究 文档描述了一种“虚拟对手”策略,其中参与者被告知他们正在与另一名参与者对战,但另一方实际上是进行随机选择的算法。这种方法是真正的 AI 联合体思想的祖先,但限制较大:随机选择算法无法进行脚本化的社会压力交流、谈判或维持一个可信的欺骗对话。生成型 AI 增加的是产生自然、上下文响应语言的能力,在某些设计中还包括音频或图像,取代人类联合体的现场即兴演出,这使得该方法适用于随机选择算法无法支持的范式。


AI 联合体的论证

AI 联合体并不是人类联合体的完全替代品;它是另一种可行的选项,并且在某些设计中更强大。四个考虑因素支持这一点:控制性、可重复性、伦理和规模。

控制性

训练有素的人类联合体被要求在每个参与者中再现固定的行为协议:相同的语气、相同的抵触、相同的谈判任务中让步的时机。在实践中,联合体会偏离。疲劳、情绪和进行多个会话的累积经验都引入了研究者未设计的变异,这种变异是一种混淆因素,因为它与时间和会话顺序相关,而不是与实验操控相关。从固定提示和固定配置生成的 AI 代理不会像人一样感到疲劳或积累会话经验,这消除了该特定来源的会话间漂移,尽管它引入了自己的一致性要求(见下文)。

在 Labvanced 的实现中: 相同的 Send to OpenAI 配置在每个任务会话中保持不变,因为它是固定设置,而不是需要一个人每次从记忆中再现的协议。

可重复性

人类联合体的确切行为在方法部分中很少被完全规范化。即使是详细的脚本也留有空白,由人类演员用判断填补,因此,尝试复制该研究的不同实验室是在再现原始联合体表现的近似,而不是表现本身。经过文档化的提示、模型版本和生成参数是完整的、可移植的规范:另一个实验室可以运行同一配置,而不是训练一名新的演员来近似原始的表现。

在 Labvanced 的实现中: 模型版本、温度和提示本身直接保存在任务配置中,因此本节要求的完整规范不是额外的文档工作,而是已经存储的内容。

伦理

用真实的人类同伙欺骗参与者具有伦理负担,许多机构审查流程通常要求研究者进行合理解释和解密:在某种意义上,实际的人参与了该欺骗。AI 生成的联合体改变了这种安排的伦理性质,尽管它并不能消除研究设计中的根本欺骗,仍然需要与任何欺骗范式相同的解密和同意处理。这软化了联合体使用的一个特定伦理维度;它并没有使欺骗范式整体上变得伦理上更简单。

规模

在线和远程研究可以招募比单个实验室会话更多的参与者,这就创造了一个特定于人类联合体的规模问题:每增加一名参与者需要另一个联合体会话,因此更大的样本意味着需要招聘、培训和安排更多的联合体,同时还需要确保所有人的行为在每个会话中与彼此一致,除此之外还有控制(上述)中已经涵盖的联合体内漂移。AI 联合体没有这个问题。同样的配置在第千个参与者身上运行时与第一次一样,没有额外的人员、培训或联合体间一致性检查需要管理。这使得 AI 联合体特别适合大样本的在线研究。

在Labvanced的实现中: 同样的AI同盟配置在收集20名参与者或2000名参与者时均未修改运行,因为这是一个任务设置,而非必须随着样本大小扩展的人员配置。


使用AI同盟的 методологические考虑

采用AI同盟并不是一个即插即用的选择。它引入了自己的设计要求,跳过这些要求只会将人类同盟的混淆替换为模型同盟的混淆。

将AI行为作为独立变量控制

如果AI同盟的反应在参与者之间不可预测地变化,无论是在语气上,还是在合作或不合作的外观上,还是在响应长度上,研究就重新引入了AI同盟旨在消除的那种不受控制的变化。Labvanced的AI和心理学研究集成,基于本地OpenAI文本、图像和音频生成,揭示了研究人员需要将同盟的行为视为受控变量而非假设的具体参数:

  • 在研究期间固定的Model Version,以便在会话之间的提供者侧模型更新不会在研究中途改变同盟的行为。
  • 通过Insert Message设置的详细system-角色消息,将同盟的人格和行为边界以书面形式表述,而不是依赖模型的默认判断:哪个语言注册和俚语适合参与者池,它对当前事件的意识应扩展到多远,以及如果参与者直接询问它是否是AI,它应如何反应。
  • Temperature设置在其范围的确定性端,以便于生成感觉像脚本的同盟,因为温度决定生成响应的随机与可预测之间的平衡。
  • Max Tokens限制响应长度在参与者之间保持一致,因为没有限制的同盟在一次会话到下次会话之间可能会在说话量上变化很大。
  • 对于基于音频的同盟,固定的Voice和书面的Instructions(例如,指定中立、平静的表达)以在参与者之间保持声调一致,而不是让其在每次试验中变化。
  • 一个链接的Chat History Dataframe,因此与每个参与者的完整交流被记录并可用于事后验证同盟行为的一致性,这是人类同盟的剧本遵循提供的那种审计轨迹。

这些设置共同帮助确保了genAI性能在会话之间的更高一致性。研究人员必须故意推动这些杠杆,就像人类同盟研究要求培训协议和会话间一致性检查,而不是假设一个演员会独立重现一个剧本。
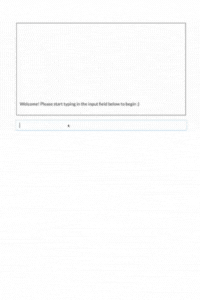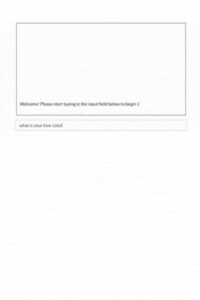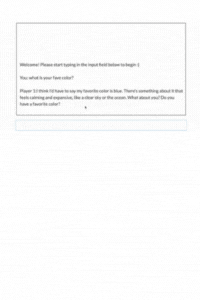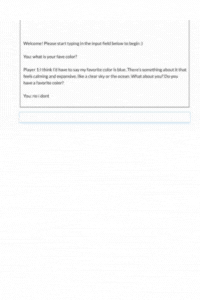
OpenAI基于文本的聊天

此模板建立了Labvanced与OpenAI之间的实时通信通道,这是任何基于此集成的同盟研究所依赖的基础。将其用作起点,并修改提示、模型和参数以适应您的范式。

注意: 对于这个特定的演示,令牌长度(即响应的长度)设置为100,温度(即创造力)设置为1。可以在研究设置下进行调整。


提示设计作为有效性变量

system-角色消息是研究人员手动撰写同盟整个行为政策的地方:其语言注册和俚语、对当前事件的意识扩展程度,以及如果参与者直接询问它是否是AI,它的反应。两个实验室在不同的俚语校准、不同的当前事件截止日期或不同的对AI问题的脚本答案下运行相同的替代,可能会得到有意义的不同同盟行为,这是一种在语言模型研究中得到很好的记录的提示敏感性(Zhuo et al., 2024)。一项研究发现参与者对AI同盟的反应与对人类的反应不同,可能表明真正的替代效应,或者可能是由于这些维度之一上的提示未规格化或设计不良。将提示设计视为一个需要报告和审查的变量,而不是一个实施细节,这就是使这两种解释可区分的原因。

在Labvanced的实现中: 这是通过Insert Message设置的system-角色消息,作为任务的一部分保存一次,而不是为每次会话新输入,这使得能够准确报告和审计如书写的内容。

相同的作者身份也引入了一种故意使用:研究人员可以在条件之间变化系统提示作为操控本身,例如,在谈判任务中合作人格同盟与竞争人格同盟。在这里,提示本身就是独立变量,故意在条件之间变化而非保持不变,方法学标准也相应转变:提示变体只需在预期维度(合作与竞争)上不同,而不是在其他方面(长度、正式性、词汇)偶然不同,否则操控在研究开始之前就已经混淆。此处对参与者实际上如何在预期维度上感知同盟的操控检查成为必要,与试点测试确认人类同盟的脚本人格如预期出现的方式相同。

范式适应性

AI同盟适合于可以事先指定或从有限的响应类型集合生成的交互范式、欺骗场景、结构化社会压力交换、具有明确报价空间的谈判和讨价还价任务。AI谈判研究是此处最清晰的适应之一,因为报价和还价都在定义的空间内,而不需要开放式即兴创作。它不太适合于依赖同盟在那个有限空间外自信即兴演出的交互范式,或在需要参与者相信他们正在与同一地位的人类同行打交道的情境中的欺骗,往往一旦被怀疑AI的存在,操控就会完全崩溃。

在Labvanced的实现中: Send to OpenAI动作生成同盟在单一参与者研究中的欺骗、社会压力或谈判交换的一方。同盟不是第二个真实的连接用户,因此构建这些范式并不需要Labvanced的多用户基础设施,参与者的会话是唯一实时的会话。

范式类型AI 联合体适用原因
预设欺骗(假共参与者,确认操控)适合行为可以提前完全规范;无需现场即兴发挥
结构化的社会压力交换(合作者合作/背叛信任或困境游戏)适合响应空间是有限的(合作、背叛、特定消息类型),适合受控提示
具有明确定义的提供空间的谈判和讨价还价任务适合可以在记录的参数内生成报价和反报价
开放式即兴社会互动不适合依赖于令人信服的、非剧本化的人类即兴表现,超出有限响应集
信念以同等地位的人类同伴为操控载体的设计需要先进行操控检查如果怀疑存在 AI 的存在,欺骗就会崩溃;是否成立是一个开放的实证问题,而不是一个固定的假设

开放的有效性问题

有待直接测试的是,处于信任游戏、顺从范式或谈判任务中的参与者是否会像受到人类联合体欺骗的一样表现。替代的方式还比较新,因此尚未进行这种面对面的比较。怀疑或发现 AI 存在的可能性可能会改变互动的社会风险,这与人类联合体不同,这意味着 AI 联合体交易掉了人类一致性的干扰,而不是简单地移除一个干扰。严格使用 AI 联合体将此视为一个开放的实证问题,以检查,例如,参与者是否正确相信自己正在与人类互动,而不是通过设计解决的假设。


常见问题解答

AI 可以取代心理实验中的人类联合体吗?
方法论上可以,在可以提前指定联合体行为或在有限响应空间内生成的范式中,欺骗场景、结构化社会压力交换和谈判任务是最清晰的适用例。支持这一观点的是对控制、可复制性、规模以及与欺骗参与者的现场人类同伴相比,伦理权重的减少(而非消除)。参与者的行为是否与人类联合体相同是另一个当前开放的实证问题。
AI 联合体和人类-AI 互动研究有什么区别?
在 AI 联合体设计中,AI 代表经典范式中的人类角色,包括欺骗、社会压力和谈判,它是工具,而不是被测量的内容。在人类-AI 互动研究中,AI 本身是主题:研究问题是关于人们如何响应 AI(信任校准、劝说、聊天机器人用户体验),参与者通常知道自己正在与 AI 互动,而不是被引导相信其他事情。
使用 AI 联合体是否会引入人类联合体没有的有效性问题?
有可能。AI 联合体消除了人类演员通过疲劳和积累经验引入的会话间漂移,但如果其行为没有被故意控制(模型版本、温度,对于音频联合体,声音和发声指令),可能会引入自身的不一致性。也存在一个开放性问题,即当怀疑或确认存在 AI 时,参与者的响应是否有所不同,人类联合体研究则不必以相同方式考虑这一点。
AI 联合体适合哪些范式?
适合有限响应空间的范式:预设欺骗、结构化社会压力交换(合作/背叛风格互动)和具有明确定义提供空间的谈判或讨价还价任务。它不太适合开放式即兴社会互动,以及那些具体依赖于参与者相信他们正在与同等地位的人类同伴互动的设计,因为一旦怀疑存在 AI,就可能会崩溃这种信念。
使用 AI 联合体是否与 AI 欺骗研究相同?
AI 联合体是进行 AI 欺骗研究的一种方式,而不是它的同义词。AI 欺骗研究是一个更广泛的类别:任何通过对参与者隐瞒或误表现人工智能代理的参与。AI 联合体是特定案例,其中该隐蔽的 AI 代表人类同伴在经典范式内,如欺骗、社会压力或谈判,而不是,例如,AI 安静地生成参与者被告知来自人类来源的刺激。

深入阅读

AI 与心理学研究

AI 与心理学研究

平台能力:原生 OpenAI 文本、图像和音频生成直接嵌入实验流程。

发送至 OpenAI 动作

发送至 OpenAI 动作

实施指南:用于配置受控 AI 联合体的动作和参数(模型版本、温度、声音、指令)。


正在设计双人或小组互动,并希望获得更广泛的背景? 心理学研究中的双人效应涵盖了另一个方参与者的存在如何改变成对设计中个体行为的情况,这与人类或 AI 联合体操作的领域相同。相关模式在涉及多个方时出现,见于 团队动态研究。

当谈判或讨价还价范式作为目标设计时, 出价游戏任务页面是适合 AI 联合体在有限报价空间内部生成的具体示例。