AI-Konföderierter: Methodologie und Validität
Ein AI-Konföderierter ist ein skriptbasierter oder modellgesteuerter Agent, der einen menschlichen Komplizen in Täuschungs-, sozialem Druck- und Verhandlungsparadigmen ersetzt. Im Gegensatz zu einem trainierten menschlichen Konföderierten kann sein Verhalten genau spezifiziert, protokolliert und über alle Teilnehmer hinweg reproduziert werden, was das zentrale methodologische Argument für seine Verwendung ist und auch der Grund, warum er als Designentscheidung bewertet und nicht standardmäßig angenommen werden sollte.
Diese Seite behandelt AI als ein Werkzeug, das für eine menschliche Rolle innerhalb eines ansonsten klassischen Paradigmas steht: Die AI ist das Instrument, nicht das, was gemessen wird. Das ist eine andere Frage als Studien, in denen die AI selbst das Untersuchungsobjekt ist, was im FAQ unten behandelt wird.
Inhaltsverzeichnis
Was zählt als AI-Konföderierter
Ein Konföderierter ist im klassischen Sinne jemand, der dem Teilnehmer als ein anderer Teilnehmer oder ordentlicher Interaktionspartner erscheint, aber tatsächlich auf einem Skript agiert, das der Experimentator kontrolliert, am vertrautesten aus Täuschungsparadigmen (ein falscher Mitteilnehmer in einer Konformitätsstudie), sozialen Druck-Paradigmen (ein Partner, der in einem Vertrauensspiel unkooperativ agiert) und Verhandlungs- oder Aushandlungsaufgaben (ein Gegenüber, dessen Angebote einem vorher festgelegten Muster folgen). Ein AI-Konföderierter ersetzt diesen menschlichen Komplizen durch einen modellgesteuerten Agenten: Der Teilnehmer glaubt weiterhin oder wird dazu gebracht zu glauben, dass er mit einer anderen Partei in der Studie interagiert, aber die Antworten dieser Partei werden durch ein AI-System generiert oder skriptiert, anstatt von einem trainierten menschlichen Akteur aufgeführt zu werden.
Dies ist kein neues experimentelles Design. Es ist ein alternativer Ansatz innerhalb bereits existierender Designs, und das Feld hat bereits eine weniger technologische Version derselben Idee: Labvanceds eigene Multi-User-Studien dokumentiert eine "virtuelle Gegner"-Strategie, bei der einem Teilnehmer gesagt wird, dass er gegen einen anderen Teilnehmer spielt, aber die andere Seite tatsächlich ein Algorithmus ist, der zufällige Entscheidungen trifft. Dieser Ansatz ist ein echter Vorfahr der Idee des AI-Konföderierten, aber ein begrenzter: Ein Algorithmus für zufällige Entscheidungen kann keinen skriptierten Austausch von sozialem Druck aufrechterhalten, verhandeln oder ein glaubwürdiges täuschendes Gespräch führen. Was generative AI hinzufügt, ist die Fähigkeit, natürliche, kontextabhängige Sprache zu produzieren, und in einigen Designs Audio oder Bilder, anstelle der Live-Improvisation eines menschlichen Konföderierten, was diesen Ansatz für Paradigmen, die ein Algorithmus für zufällige Entscheidungen nie unterstützen könnte, tragfähig macht.
Das Argument für einen AI-Konföderierten
Ein AI-Konföderierter ist kein vollwertiger Ersatz für einen menschlichen; er ist eine andere gangbare und in einigen Designs mächtigere Option. Vier Überlegungen sprechen dafür: Kontrolle, Replizierbarkeit, Ethik und Skalierung.
Kontrolle
Ein trainierter menschlicher Konföderierter wird gebeten, ein festgelegtes Verhaltensprotokoll bei allen Teilnehmern zu reproduzieren: denselben Ton, denselben Widerstand, denselben Zeitpunkt eines Zugeständnisses in einer Verhandlungsaufgabe. In der Praxis driften Konföderierte. Müdigkeit, Stimmung und die angesammelte Erfahrung, viele Sitzungen durchzuführen, bringen alle Variationen mit sich, die der Forscher nicht eingeplant hat, und diese Variation ist ein Störfaktor, weil sie mit der Zeit und der Sitzungsreihenfolge korreliert und nicht mit der experimentellen Manipulation. Ein AI-Agent, der von einem festen Prompt und einer festen Konfiguration erzeugt wird, ermüdet oder sammelt keine Sitzungserfahrung auf die Weise, wie es eine Person tut, wodurch diese spezifische Quelle des Drift zwischen den Sitzungen entfernt wird, obwohl sie eigene Konsistenzanforderungen einführt (siehe unten).
In Labvanceds Implementierung: dieselbe Send to OpenAI Konfiguration läuft unverändert für jede Sitzung zu der Aufgabe, da es eine feste Einstellung ist, die keine Protokollierung erfordert, die eine Person jedes Mal aus dem Gedächtnis reproduzieren muss.
Replizierbarkeit
Das genaue Verhalten eines menschlichen Konföderierten ist selten vollständig im Methodikabschnitt spezifiziert. Selbst ein detailliertes Skript lässt Lücken, die ein menschlicher Akteur mit Urteilsvermögen schließt, sodass ein anderes Labor, das versucht, die Studie zu replizieren, eine Annäherung an die Leistung des ursprünglichen Konföderierten reproduziert, nicht die Leistung selbst. Ein dokumentierter Prompt, Modellversion und Erzeugungsparameter sind eine vollständige, tragbare Spezifikation: Ein anderes Labor kann die identische Konfiguration verwenden, anstatt einen neuen Akteur auszubilden, um den ursprünglichen nachzuahmen.
In Labvanceds Implementierung: Modellversion, Temperatur und der Prompt selbst werden direkt in der Aufgaben-Konfiguration gespeichert, sodass die vollständige Spezifikation, die dieser Abschnitt fordert, keine zusätzliche Dokumentationsarbeit ist, sondern bereits gespeichert ist.
Ethik
Die Täuschung eines Teilnehmers durch einen lebenden menschlichen Komplizen trägt ein ethisches Gewicht, das die meisten institutionalisierten Überprüfungsprozesse von Forschern bereits verlangen, zu rechtfertigen und aufzuklären: Eine tatsächliche Person war in gewissem Sinne an der Täuschung beteiligt. Ein AI-generierter Konföderierter ändert die ethische Beschaffenheit dieser Anordnung, obwohl er die zugrunde liegende Täuschung im Studiendesign selbst nicht entfernt, die immer noch die gleiche Aufklärung und Einwilligungsbehandlung erfordert, die jedes Täuschungsparadigma erfordert. Dies mildert eine spezifische ethische Dimension der Verwendung von Konföderierten; es macht Täuschungsparadigmen insgesamt nicht ethisch einfacher.
Skalierung
Online- und Remote-Studien können weit mehr Teilnehmer rekrutieren, als eine einzige Laborsitzung jemals könnte, und das schafft ein spezifisches Skalierungsproblem für menschliche Konföderierte: Jeder zusätzliche Teilnehmer benötigt eine weitere Konföderierten-Sitzung, sodass eine größere Stichprobe bedeutet, mehr Konföderierte zu rekrutieren, auszubilden und zu planen und außerdem sicherzustellen, dass sie sich verhaltenstechnisch konsistent sind, zusätzlich zu dem bereits abgedeckten Drift innerhalb der Konföderierten Kontrolle (oben). Ein AI-Konföderierter hat dieses Problem nicht. Die gleiche Konfiguration läuft für den tausendsten Teilnehmer genau so wie für den ersten, ohne zusätzliches Personal, Ausbildung oder Überprüfungen zur Konsistenz zwischen den Konföderierten zu verwalten. Das ist es, was einen AI-Konföderierten besonders gut für die Online-Forschung mit großen Stichproben geeignet macht.
In Labvanced's Implementierung: Die gleiche AI-Conferent-Konfiguration läuft unverändert, egal ob eine Studie 20 Teilnehmer oder 2.000 sammelt, da es sich um eine Aufgabeneinstellung handelt, die mit der Stichprobengröße skalieren muss.
Methodologische Überlegungen beim Einsatz von AI-Conferenten
Die Einführung eines AI-Conferenten ist keine Plug-and-Play-Entscheidung. Sie bringt eigene Designanforderungen mit sich, und das Übergehen dieser Anforderungen ersetzt einfach eine menschliche Conferent-Störung durch eine Modell-Conferent-Störung.
Steuerung des AI-Verhaltens als unabhängige Variable
Wenn die Antworten des AI-Conferenten unvorhersehbar zwischen den Teilnehmern variieren, im Ton, in der Zusammenarbeit oder Nicht-Zusammenarbeit, in der Länge der Antworten, hat die Studie genau die Art von unkontrollierter Variation wieder eingeführt, die ein AI-Conferent entfernen soll. Labvanced's Integration von AI und psychologischer Forschung, die auf nativer OpenAI-Text-, -Bild- und -Audio-Generierung basiert, zeigt die spezifischen Parameter auf, die ein Forscher benötigt, um das Verhalten des Conferenten als kontrollierte Variable und nicht als Annahme zu behandeln:
- Ein
Model Version, das während der Studiendauer festgelegt ist, damit ein Anbieter-seitiges Modell-Update zwischen den Sitzungen das Verhalten des Conferenten nicht mitten in der Studie ändern kann. - Eine detaillierte
system-Rollen-Nachricht, die überInsert Messagefestgelegt wird, die die Persona und Verhaltensgrenzen des Conferenten schriftlich festhält, anstatt sie dem Standardurteil des Modells zu überlassen: welcher Sprachstil und welche Umgangssprache zur Teilnehmergruppe passen, wie weit das Bewusstsein für aktuelle Ereignisse reichen sollte und wie es reagieren sollte, wenn ein Teilnehmer direkt fragt, ob es eine AI ist. Temperatureauf das deterministische Ende seines Bereichs eingestellt für einen scriptähnlichen Conferenten, da die Temperatur steuert, wie zufällig versus vorhersehbar die generierte Antwort ist.Max Tokensbegrenzt, um die Antwortlänge zwischen den Teilnehmern konsistent zu halten, da ein unbegrenzter Conferent darin variieren kann, wie viel er von einer Sitzung zur nächsten sagt.- Für audio-basierte Conferenten, ein festgelegtes
Voiceund eine schriftlicheInstructions(zum Beispiel, die eine neutrale, ruhige Lieferung spezifiziert), um den Stimmton zwischen den Teilnehmern konstant zu halten, anstatt ihn von Versuch zu Versuch variieren zu lassen. - Ein verlinktes
Chat History Dataframe, damit der volle Austausch mit jedem Teilnehmer protokolliert und für eine nachträgliche Überprüfung verfügbar ist, dass der Conferent konsistent gehandelt hat, die gleiche Art von Audit-Trail, die eine Manipulationskontrolle für die Skriptbefolgung eines menschlichen Conferenten bietet.
Zusammen helfen diese Einstellungen, eine größere Konsistenz für die genAI-Leistung über Sitzungen hinweg zu gewährleisten. Sie sind Hebel, die ein Forscher absichtlich betätigen muss, genau wie eine Studie mit menschlichen Conferenten ein Trainingsprotokoll und Inter-Sitzungs-Fidelitätsprüfungen erfordert, anstatt anzunehmen, dass ein Schauspieler ohne Hilfe ein Skript reproduzieren wird.
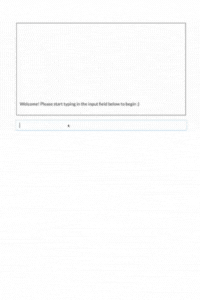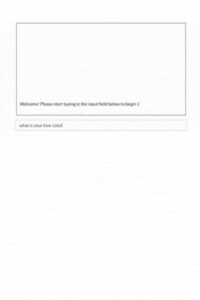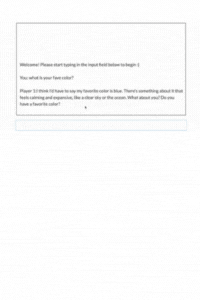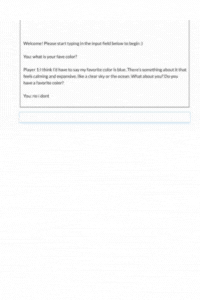
Diese Vorlage richtet den Echtzeit-Kommunikationskanal zwischen Labvanced und OpenAI ein, auf dem jede auf dieser Integration basierende Conferent-Studie beruht. Verwenden Sie es als Ausgangspunkt und modifizieren Sie den Prompt, das Modell und die Parameter, um zu Ihrer Paradigma zu passen.
Hinweis: Für diese besondere Demo ist die Tokenlänge (d.h. die Länge der Antwort) auf 100 eingestellt und die Temperatur (d.h. Kreativität) auf 1. Dies kann unter den Studieneinstellungen angepasst werden.
Prompt-Design als Validitätsvariable
Die system-Rollen-Nachricht ist der Ort, an dem der Forscher die gesamte Verhaltenspolitik des Conferenten von Hand schreibt: seinen Sprachstil und Slang, wie weit sein Bewusstsein für aktuelle Ereignisse reicht, und wie er reagiert, wenn ein Teilnehmer direkt fragt, ob er eine AI ist. Zwei Labore, die dieselbe Substitution mit unterschiedlichen Slang-Kalibrierungen, einem anderen Cutoff für aktuelle Ereignisse oder einer anderen skriptbasierten Antwort auf die AI-Frage durchführen, könnten signifikant unterschiedlich auf das Verhalten des Conferenten auswirken, eine Form von Prompt-Empfindlichkeit, die in der Forschung zu Sprachmodellen gut dokumentiert ist (Zhuo et al., 2024). Eine Studie, die herausfindet, dass Teilnehmer unterschiedlich auf einen AI-Conferenten als auf einen menschlichen reagieren, könnte einen echten Substitutionseffekt erfassen, oder sie könnte einen unter-spezifizierten oder schlecht gestalteten Prompt in einer dieser Dimensionen erfassen. Die Behandlung des Prompt-Designs als Variable, die gemeldet und untersucht werden sollte, anstatt als Implementierungsdetail, macht die beiden Erklärungen unterscheidbar.
In Labvanced's Implementierung: dies ist die system-Rollen-Nachricht, die über Insert Message festgelegt wird, einmal als Teil der Aufgabe gespeichert, anstatt für jede Sitzung neu eingegeben zu werden, was es ermöglicht, genau so zu berichten und zu prüfen, wie es geschrieben wurde.
Die gleiche Urheberschaft öffnet auch eine gezielte Nutzung: Ein Forscher kann den System-Prompt über die Bedingungen hinweg variieren, um die Manipulation selbst zu schaffen, zum Beispiel einen kooperativen-Partner-Conferenten versus einen kompetitiven-Partner-Conferenten in einer Verhandlungsaufgabe. Hier ist der Prompt selbst die unabhängige Variable, absichtlich über die Bedingungen hinweg variiert, anstatt konstant gehalten zu werden, und die methodologische Schwelle verschiebt sich entsprechend: Prompt-Varianten müssen sich nur entlang der beabsichtigten Dimension (kooperativ vs. wettbewerbsfähig) unterscheiden, aber nicht zufällig entlang anderer (Länge, Formalität, Wortschatz), oder die Manipulation wird konfundiert, bevor die Studie beginnt. Eine Manipulationsüberprüfung, wie die Teilnehmer den Conferenten tatsächlich entlang der beabsichtigten Dimension wahrnehmen, wird hier wesentlich, genau wie ein Pilot-Test bestätigen würde, dass die Skript-Persona eines menschlichen Conferenten so wahrgenommen wird, wie beabsichtigt.
Paradigma-Eignung
Ein AI-Conferent passt zu Paradigmen, in denen die Interaktion im Voraus spezifiziert oder aus einer begrenzten Anzahl von Antworttypen generiert werden kann, Täuschungsszenarien, strukturierte soziale Druckaustausch, Verhandlungs- und Preisverhandlung Aufgaben mit einem definierten Angebotsraum. Eine AI-Verhandlungsstudie ist hier eine der klarsten Eignungen, da Angebote und Gegenangebote innerhalb eines definierten Raums liegen, anstatt offene Improvisation zu verlangen. Es passt weniger gut zu Paradigmen, bei denen die Interaktion davon abhängt, dass der Conferent außerhalb dieses begrenzten Raums überzeugend improvisiert, oder wo die Täuschung speziell darauf beruht, dass der Teilnehmer glaubt, er würde mit einem gleichgestellten menschlichen Kollegen in einem Kontext zu tun haben, in dem eine AI-Präsenz, einmal vermutet, die Manipulation vollständig zusammenbrechen würde.
In Labvanced's Implementierung: die Send to OpenAI-Aktion generiert die Seite des Conferenten in einem Täuschungs-, sozialen Druck- oder Verhandlungsaustausch innerhalb einer Einzel-Teilnehmer-Studie. Der Conferent ist kein zweiter realer verbundener Benutzer, sodass der Aufbau dieser Paradigmen nicht die Multi-User-Infrastruktur von Labvanced erfordert, die Sitzung des Teilnehmers ist die einzige aktive.
| Paradigmenart | Eignung des KI-Konföderierten | Warum |
|---|---|---|
| Skriptierte Täuschung (falscher Co-Teilnehmer, Bestätigungsmanipulation) | Gut geeignet | Verhalten kann vollständig im Voraus spezifiziert werden; keine Live-Improvisation erforderlich |
| Strukturierter sozialer Druckaustausch (Partnerschaftskooperation/-defektion in einem Vertrauens- oder Dilemmaspiel) | Gut geeignet | Der Antwortbereich ist begrenzt (kooperieren, defektieren, spezifische Nachrichtentypen), geeignet für ein kontrolliertes Prompt |
| Verhandlungs- und Aushandlungsaufgaben mit einem definierten Angebotsraum | Gut geeignet | Angebote und Gegenangebote können innerhalb dokumentierter Parameter generiert werden |
| Offene, improvisierte soziale Interaktion | Schlecht geeignet | Hängt von überzeugender, unskriptierter, menschenähnlicher Improvisation außerhalb eines begrenzten Antwortsatzes ab |
| Designs, bei denen der Glaube an einen menschlichen Peer im gleichen Status das tragende Element der Manipulation ist | Benötigt zunächst eine Manipulationsprüfung | Wenn die KI-Präsenz vermutet wird, bricht die Täuschung zusammen; ob sie standhält, ist eine offene empirische Frage, keine gegebene |
Die offene Validitätsfrage
Ob ein Teilnehmer, der von einem KI-gesteuerten Konföderierten getäuscht wird, sich genauso verhält wie einer, der von einem menschlichen Konföderierten getäuscht wird, in einem Vertrauensspiel, einem Konformitätsparadigma oder einer Verhandlungsaufgabe, wurde noch nicht direkt getestet: Die Substitution ist neu genug, dass dieser direkte Vergleich einfach noch nicht durchgeführt wurde. Es ist plausibel, dass das Verdacht oder die Entdeckung einer KI-Präsenz die sozialen Einsätze der Interaktion in einer Weise verändert, die ein menschlicher Konföderierter nicht tut, was bedeuten würde, dass ein KI-Konföderierter einen menschlichen Konsistenzkonfound gegen einen anderen, KI-spezifischen eintauscht, anstatt einfach einen Konfound zu entfernen. Ein rigoroser Einsatz eines KI-Konföderierten betrachtet dies als offene empirische Frage, die zu überprüfen ist, beispielsweise durch eine Manipulationsprüfung, ob die Teilnehmer korrekt glaubten, sie würden mit einem Menschen interagieren, anstatt eine Annahme, die durch das Design gelöst wird.
Häufig gestellte Fragen
Weiterführende Literatur
KI und Psychologieforschung
Plattformfähigkeit: native OpenAI-Text-, Bild- und Audioerzeugung direkt im experimentellen Ablauf eingebettet.
An OpenAI-Aktion senden
Implementierungsleitfaden: die Aktion und die Parameter (Modellversion, Temperatur, Stimme, Anweisungen), die verwendet werden, um einen kontrollierten KI-Konföderierten zu konfigurieren.
Arbeiten Sie an einem dyadischen oder Gruppeninteraktionsdesign und wollen den breiteren Kontext? Der dyadische Effekt in der psychologischen Forschung behandelt, wie die Anwesenheit einer anderen Partei das individuelle Verhalten in gepaarten Designs verändert, im gleichen Bereich, in dem ein menschlicher oder KI-Konföderierter agiert. Ein verwandtes Muster tritt überall dort auf, wo mehr als ein einfaches Paar beteiligt ist, behandelt in Forschung zu Teamdynamik.
Wo ein Verhandlungs- oder Aushandlungsparadigma das Ziel-Design ist, ist die Ultimatum-Spiel Aufgabendetailseite ein konkretes Beispiel für die Struktur eines begrenzten Angebotsraums, die ein KI-Konföderierter gut generieren kann.