labvanced logoLabVanced
  • Research
    • Publications
    • Researcher Interviews
    • Use Cases
      • Developmental Psychology
      • Linguistics
      • Clinical & Digital Health
      • Educational Psychology
      • Cognitive & Neuro
      • Social & Personality
      • Arts Research
      • Sports & Movement
      • Marketing & Consumer Behavior
      • Economics
      • HCI / UX
      • Commercial / Industry Use
    • Labvanced Blog
    • Services
  • Technology
    • Feature Overview
    • Code-Free Study Building
    • Eye Tracking
    • Mouse Tracking
    • Generative AI Integration
    • Multi User Studies
    • More ...
      • Reaction Time/Precise Timing
      • Text Transcription
      • Heart Rate Detection (rPPG)
      • Emotion Detection
      • Questionnaires/Surveys
      • Experimental Control
      • Data Privacy & Security
      • Desktop App
      • Mobile App
  • Learn
    • Guide
    • Videos
    • Walkthroughs
    • FAQ
    • Release Notes
    • Documents
    • Classroom
  • Experiments
    • Cognitive Tests
    • Sample Studies
    • Public Experiment Library
  • Pricing
    • Licenses
    • Top-Up Recordings
    • Subject Recruitment
    • Study Building
    • Dedicated Support
    • Checkout
  • About
    • About Us
    • Contact
    • Downloads
    • Careers
    • Impressum
    • Disclaimer
    • Privacy & Security
    • Terms & Conditions
    • Third-Party Licenses
  • Appgo to app icon
  • Logingo to app icon
Learn
指南
视频
步骤说明
常见问题解答
通讯档案
文档
课堂
  • 中國人
  • Deutsch
  • Français
  • Español
  • English
  • 日本語
指南
视频
步骤说明
常见问题解答
通讯档案
文档
课堂
  • 中國人
  • Deutsch
  • Français
  • Español
  • English
  • 日本語
  • 指南
    • 入门

      • 任务编辑器
      • 帧
        • 画布框架
        • 页面框架
        • 网站框架
      • 试验时间线
      • 刺激呈现
      • 响应的正确性
      • 对象
      • 事件
      • 变量
      • 任务向导
      • 试验系统
      • 实验设计
        • 创建研究
        • 数据框模式
        • 多用户实验设计
        • 纵向实验设计
    • 特色主题

      • 随机化与平衡
      • 眼动追踪
        • 在眼动追踪任务中呈现刺激
        • 如何选择眼动追踪校准设置
        • 在任务中设置眼动追踪
        • 记录和导出注视数据
        • 使用形状作为眼动追踪的兴趣区域 (AOI)
        • 参与者校准体验
      • 网页桥接
        • 选择网站 AOI | 锚定、调整和验证 AOI 跟踪
        • 在网站 AOI 上跟踪鼠标行为 | Web Bridge 指南
      • 问卷
      • 桌面应用
      • 示例研究
      • 参与者招募
      • API 访问
        • REST API
        • Webhook API
        • WebSocket API
      • 其他主题

        • 精确刺激时间
        • 多用户研究
        • Labvanced中的头部追踪 | 指南
    • 主应用标签

      • 概述:主标签
      • 仪表板
      • 我的研究
      • 共享研究
      • 我的文件
      • 实验库
      • 我的账户
      • 许可与服务
    • 研究标签

      • 概述:研究特定标签
      • 研究设计
        • 任务
        • 阻塞
        • 会议
        • 组
      • 任务编辑器
        • 任务控制
        • 试验系统
        • 框架类型
        • 对象
        • 对象属性表
        • 变量
        • 系统变量表
        • 事件系统
        • 文本编辑器功能
        • 任务编辑器中的眼动追踪选项
        • 任务中的头部追踪
        • 多用户研究
      • 设置
      • 变量
      • 媒体
      • 文本与翻译
      • 启动与参与
      • 受试者管理
      • 数据视图和导出
        • 数据视图和变量 & 任务选择(旧版本)
        • 访问录音(旧版本)
  • 视频
    • 视频概览
    • 在 Labvanced 中开始使用
    • 创建任务
    • 元素视频
    • 事件与变量
    • 高级主题
  • 讲解
    • 简介
    • 斯特鲁普任务
    • 词汇决策任务
    • 波斯纳注视提示任务
    • 改变失明闪烁范例
    • 眼动追踪样本研究
    • 婴儿眼动追踪研究
    • 鼠标追踪注意捕获研究
    • 快速串行视觉呈现
    • ChatGPT 研究
    • 眼动追踪演示:图形作为 AOI
    • 多人演示:显示被试的光标
    • 手柄 / 摇杆控制器 - 基本设置
    • 具有 EEG 集成的桌面应用研究
    • 被试组平衡与变量设置
    • 构建多用户研究
    • 网站框架眼动追踪讲解
    • 条件性网络摄像头眼动追踪
  • 常见问题
    • 功能
    • 支持政策与指南
    • 安全与数据隐私
    • 许可
    • Labvanced 的精确度
    • 编程使用与 API
    • 离线使用 Labvanced
    • 故障排除
    • 研究创建问题
  • 新闻通讯档案
  • 文档
  • 课堂
Send to OpenAI Action将信息从Labvanced实验发送到OpenAI

发送到OpenAI动作

概述

Send to OpenAI 动作允许您将信息,例如字符串输入值,发送到OpenAI。您可以指定某个 Model Type 以在文本、图像或音频生成的上下文中接收提示。

注意: 为了使用此选项,您必须首先在 Settings 选项卡下列出您的API密钥。
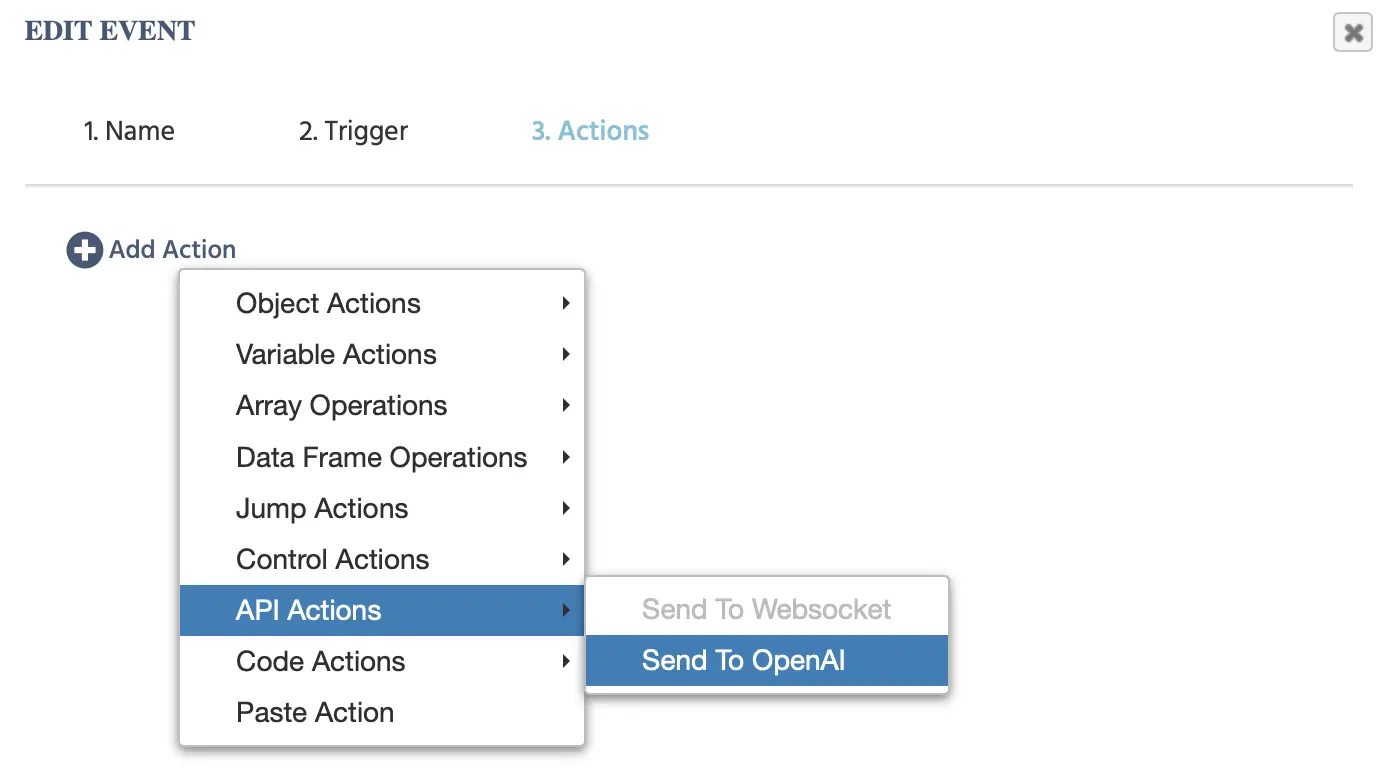
Labvanced操作菜单中的发送到OpenAI动作。

点击此事件后将出现以下选项:

发送到OpenAI动作的选项。

根据所选的 Model Category,

模型类别

模型类别描述
ChatGPT将文本输入发送到OpenAI以生成基于文本的响应。
Image Generation将文本输入发送到OpenAI以生成图像。
Generate Audio将文本输入发送到OpenAI以生成音频。

ChatGPT - 模型类别

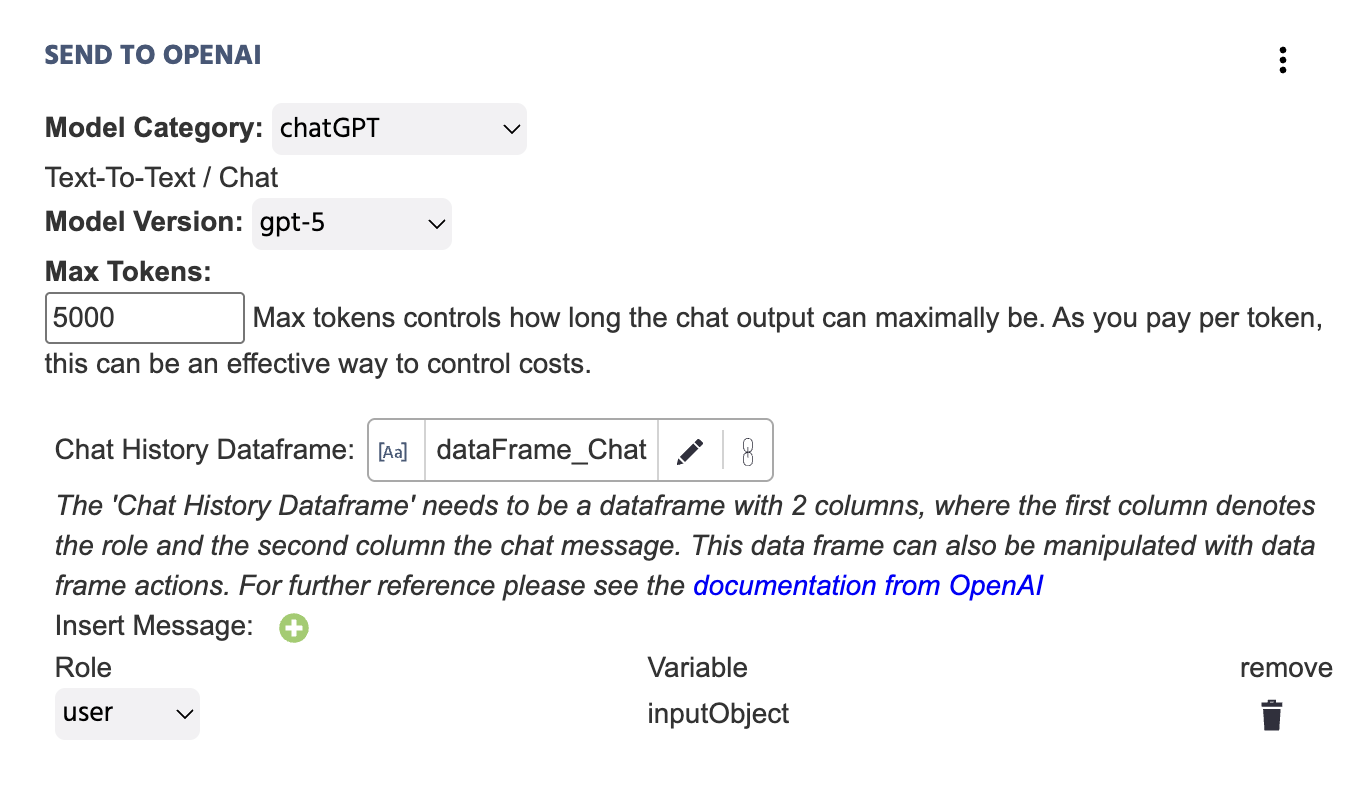
这是在提供所有必要信息时此事件的功能示例:

发送到OpenAI动作用于生成文本的示例

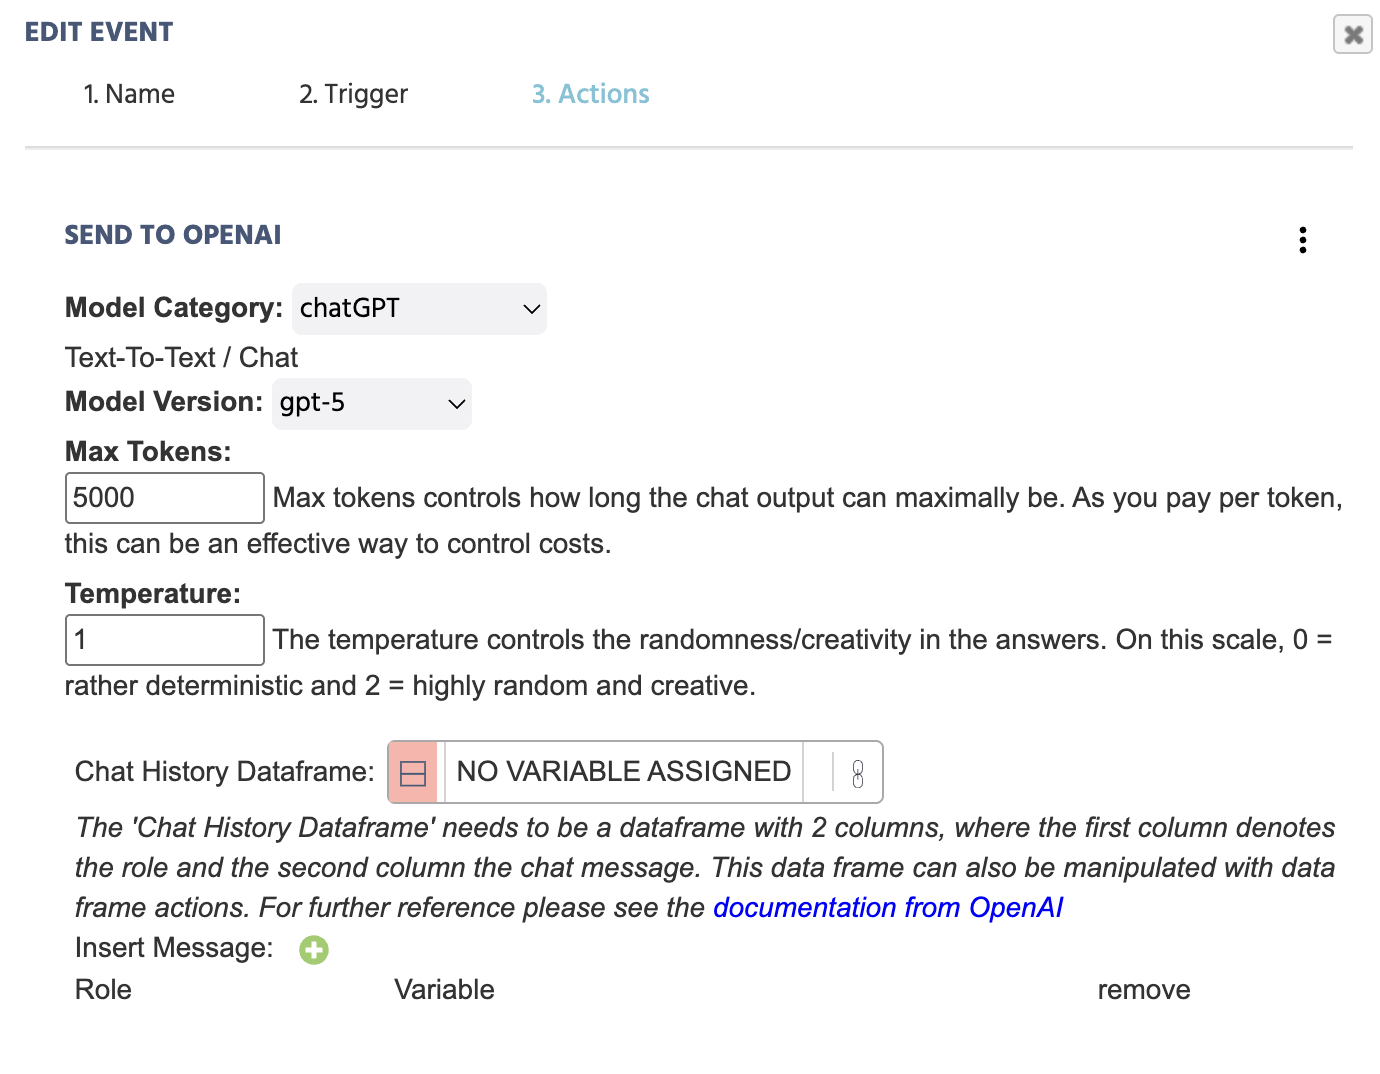
以下是对在 Send to OpenAI 动作下包含的字段的更深入解释,ChatGPT 被选为 Model Category:

菜单项'发送到OpenAI'动作选项 - ChatGPT
Model Category指定与特定动作相关的AI模型类别。在这种情况下,选择 ChatGPT 适用于文本到文本场景。有关其他选项,例如图像或音频生成,请参阅下面的部分。
Model Version指定在实验中应调用的ChatGPT版本。可用选项范围包括:
  • GPT-3.5-turbo
  • GPT-4
  • GPT-4o
  • GPT-4.1
  • GPT-5-nano
  • GPT-5-mini
  • GPT-5
Max Tokens最大令牌控制聊天输出的最大长度。由于按令牌收费,这可以是控制成本的有效方法。
Temperature温度控制答案的随机性/创造性。在该尺度上,0 = 相当确定,2 = 高度随机和创造性。
Chat History Dataframe链接到具有两列的数据框变量。第一列表示“角色”,第二列表示“聊天消息”。来自该动作的值将自动附加到此处链接的数据框中。

数据框还可以通过数据框操作进行操作。有关更多参考,请查看 OpenAI的文档。
Insert Message ‘+’ 点击此项后,将出现变量对话框。您需要指示将“变量”值发送到OpenAI以及相关消息的“角色”:
  • **系统:**指的是高层次的ChatGPT系统
  • **用户:**参与者
  • **助手:**指的是在系统内创建的特定子角色

注意1: 另请参阅 此指南,在其中我们逐步构建研究,集成ChatGPT并利用此动作。


图像生成 - 模型类别

在下面的示例中,用于存储在 Input Object 中写入文本的变量将作为 Image Prompt 发送到OpenAI,以作为此动作的结果:
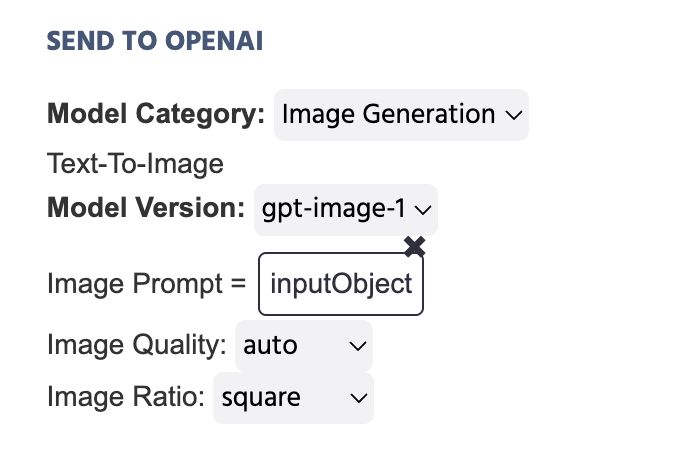
发送到OpenAI动作用于图像生成的示例。

有用的演示: 请查看 此演示,利用OpenAI触发器和动作进行图像生成。参与者被要求输入提示,然后该提示用于生成图像。

以下是对在 Send to OpenAI 动作下包含的字段的更深入解释,Image Generation 被选为 Model Category:

菜单项'发送到OpenAI'动作选项 - Image Generation
Model Category指定与特定动作相关的AI模型类别。在这种情况下,选择 Image Generation 适用于文本到图像场景。有关其他选项,例如图像或音频生成,请参阅下面的部分。
Model Version指定在实验中应调用的ChatGPT版本。可用选项包括:
  • GPT-image-1
  • DALL-E-3
Image Prompt提供您设置应生成的图像提示的选项。常见的方法包括设置 Constant Value,例如一串书面文本,或使用类似 Input Object 的变量并链接到此处。
Image Quality提示您指示将根据上述文本提示生成的图像质量。选项包括:
Image Ratio提示您指示将生成的图像的比例。
Image Style如果选择 DALL-E-3 作为 Model Version,则该选项会出现以指定图像样式。选项包括:自然和生动。

生成音频 - 模型类别

在下面的示例中,用于存储在 Input Object 中写入的文本的变量将作为 Prompt 发送到OpenAI,以作为此动作的结果:
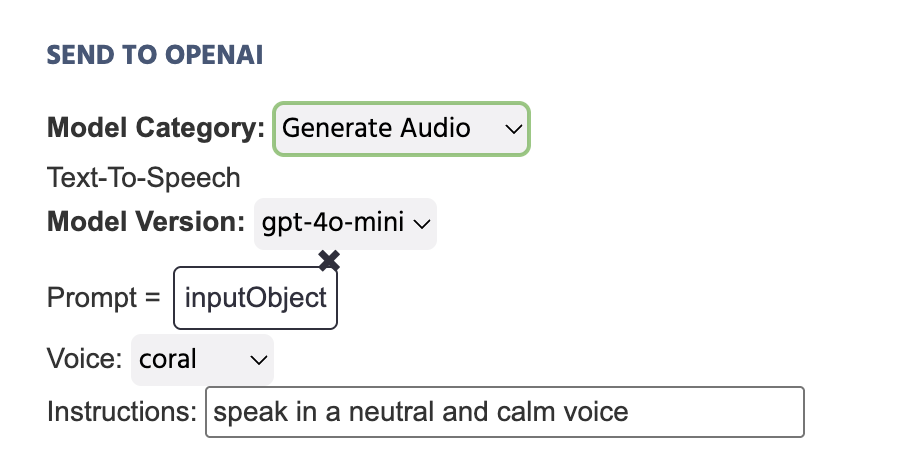
发送到OpenAI动作用于音频生成的示例。

以下是对在 Send to OpenAI 动作下包含的字段的更深入解释,Generate Audio 被选为 Model Category:

菜单项'发送到OpenAI'动作选项 - Generate Audio
Model Category指定与特定动作相关的AI模型类别。在这种情况下,选择 Generate Audio 适用于文本到音频场景。有关其他选项,例如图像或音频生成,请参阅下面的部分。
Model Version指定在实验中应调用的ChatGPT版本。可用选项包括:
  • GPT-4o-mini
Prompt提供您设置应生成的音频提示的选项。常见的方法包括设置 Constant Value,例如一串书面文本,或使用类似 Input Object 的变量并链接到此处。
Voice设置应采用的生成音频的语调。可用选项包括:
  • Alloy
  • Ash
  • Ballad
  • Coral
  • Echo
  • Onyx
  • Nova
  • Sage
  • Shimmer
  • Verse
Instructions输入进一步的指示,以使生成的音频形成,例如“用中立和平静的声音说话......”

有用的演示: 请查看 此演示,利用OpenAI触发器和动作进行音频生成。生成的文本通过OpenAI生成,并在与参与者朗读段落的上下文中使用,参与者必须回答多项选择题。

重要说明

  • 由于OpenAI每天都在发展,请查看 OpenAI的文档 以获得有关聊天的进一步说明,并考虑浏览其他模型类别的文档,例如文本到音频。